kubernetes基础 | Evergreen Notes
一、云服务
1.1 IaaS 基础设施即服务
openstack 在数以万计的物理服务器中选择一台,并将服务的接口返回给用户,用户可以在操作系统上部署服务。
核心特征: - 用户管理操作系统、中间件、运行时、应用 - 云厂商管理虚拟化、服务器、存储、网络 - 典型产品:OpenStack、AWS EC2、阿里云 ECS、腾讯云 CVM 1.2 PaaS 平台即服务
开发者只需专注于编写代码和构建应用程序本身,所有底层平台的管理工作(硬件、操作系统、中间件、运行时环境等)都由云服务提供商负责。 1.3 SaaS 软件即服务
是一种云计算服务模式,用户通过互联网直接使用云端托管的应用程序,无需本地安装。服务商负责基础设施、维护和更新,用户按订阅付费(如按月/年收费)。
核心特征: - 用户只管使用软件 - 云厂商负责所有基础设施和软件维护 - 典型产品:Google Workspace、Office 365、Salesforce、钉钉 1.3.1 三种服务模式对比
层级 用户管理 云厂商管理 典型用户 IaaS 应用、数据、运行时、中间件、OS 虚拟化、服务器、存储、网络 运维/架构师 PaaS 应用、数据 OS、中间件、运行时、基础设施 开发人员 SaaS 仅使用 全部 终端用户
二、Kubernetes 简介
2.1 什么是 Kubernetes
Kubernetes(简称 K8s)是一个开源的容器编排平台,用于自动化部署、扩展和管理容器化应用程序。它由 Google 基于其内部 Borg 系统经验设计,并于 2014 年开源捐赠给 CNCF(云原生计算基金会)。
2.2 核心优势
2.3 平台支持的规模限制
超出这些规模建议使用多集群架构(Federation / Cluster API)。
2.4 演变过程
2.5 组件架构
<!-- 这是一张图片,ocr 内容为: -->
2.6 核心组件
2.6.1 控制平面组件(Control Plane Components)
2.6.2 Node 组件
2.6.3 组件通信流程
<!-- 这是一个文本绘图,源码为:graph TB
User[kubectl / 客户端] -->|HTTPS 认证授权| API[kube-apiserver]
三、Kubernetes Pod
3.1 Pod 概念
3.1.1 Pod 使用场景
3.1.2 Pod 状态
状态 说明 Pending Pod 已被接受,但容器尚未创建(镜像拉取中、调度中) Running Pod 已绑定到节点,所有容器已创建,至少一个容器在运行 Succeeded 所有容器成功终止(exit 0),且不会重启 Failed 所有容器终止,至少一个以非零退出码退出 Unknown 无法获取 Pod 状态(通常是节点通信问题) CrashLoopBackOff 容器反复崩溃重启(kubelet 指数退避重启) ImagePullBackOff 镜像拉取失败 Terminating Pod 正在被删除
四、Kubernetes 网络
4.1 基本概述
Kubernetes 的网络模型假定所有 Pod 都在一个可以直接连通的扁平网络空间中。 这在 GCE(Google Compute Engine)中是现成的网络模型,Kubernetes 假定这个网络已经存在。 而在私有云中搭建 Kubernetes 集群,就不能假定这个网络已经存在了。
4.2 网络三大原则
在不使用网络地址转换(NAT)的情况下,集群中的 Pod 能够与任意其他 Pod 进行通信
在不使用网络地址转换(NAT)的情况下,集群节点上运行的程序能与同一节点上的任意 Pod 通信
每个 Pod 都有自己的 IP 地址(IP-per-Pod),任意其他 Pod 都可以通过这个地址访问它
4.3 常见 CNI 网络插件对比
插件 网络模型 网络策略 加密 性能 适用场景 Flannel VXLAN/Host-GW 不支持 不支持 中 简单场景、入门 Calico BGP/IPIP/VXLAN 支持 WireGuard 高 大规模、安全要求高 Cilium eBPF 支持 WireGuard 最高 高性能、可观测性 Weave VXLAN 支持 支持 中 简单易用
4.4 网络通信四层模型
4.4.1 DNS 服务发现
五、K8s 资源清单
5.1 基本概述
K8s 中所有的内容都抽象为资源,资源实例化之后叫做对象。 所有资源都可以通过 YAML 或 JSON 格式的资源清单来描述。 K8s 是声明式 API,你告诉它"期望状态",它负责达到并维持该状态。 5.2 资源类别
5.3 资源清单通用结构
5.3.1 apiVersion 速查表
Kind apiVersion 说明 Pod v1 核心 API 组 Service v1 核心 API 组 ConfigMap v1 核心 API 组 Secret v1 核心 API 组 ReplicationController v1 核心 API 组(已弃用) ReplicaSet apps/v1 推荐使用 Deployment apps/v1 推荐使用 DaemonSet apps/v1 推荐使用 StatefulSet apps/v1 推荐使用 Job batch/v1 批处理 CronJob batch/v1 定时任务 Ingress networking.k8s.io/v1 入口 HPA autoscaling/v2 水平伸缩 NetworkPolicy networking.k8s.io/v1 网络策略
六、命令详解
6.1 常用命令速览
6.2 Pod 基础命令
6.2.1 获取当前的 Pod 资源
6.2.2 进入 Pod 内部的容器执行命令
6.2.3 查看 Pod 资源的描述
6.2.4 查看 Pod 内部容器的日志
6.2.5 查看 Pod 资源对象的详细描述
6.2.6 删除资源对象
6.3 Label 标签管理
6.3.1 标签选择器
6.4 Scale 调整资源副本数量
6.5 Deployment 操作
6.5.1 查看 Deployment
6.5.2 更新镜像
6.5.3 Patch 打补丁
6.5.4 Deployment 常用命令汇总
6.5.5 Deployment 回滚命令详细说明
6.6 根据配置文件创建资源
6.6.1 三种创建方式对比
6.6.2 命令式 vs 声明式
6.7 修改在线资源
6.8 调度器相关命令
6.8.1 污点(Taint)
6.8.2 节点标签(Node Label)
6.8.3 节点封锁与驱散
七、Pod 生命周期
7.1 生命周期详解
7.1.1 从创建到死亡的全部流程
7.1.2 Pod 生命周期图示
<!-- 这是一张图片,ocr 内容为: -->
7.1.3 Pod 生命周期延伸
7.1.4 restartPolicy 重启策略
7.2 探针详解
7.2.1 探针简介
7.2.2 通用探针参数
7.2.3 readinessProbe — 就绪探针
7.2.4 livenessProbe — 存活探针
7.2.5 startupProbe — 启动探针
7.2.6 三种探针对比总结
探针类型 执行时机 失败结果 主要目的 startupProbe 容器启动后最先执行 重启容器 保护启动慢的应用 readinessProbe 启动探针成功后(全生命周期) 移出 Service 端点 控制流量是否进入 livenessProbe 启动探针成功后(全生命周期) 重启容器 检测死锁/卡死
7.3 钩子详解(Pod Hook)
八、K8s 控制器
8.1 Pod 运行调度流程图示
<!-- 这是一张图片,ocr 内容为: -->
8.2 控制器概述
8.2.1 什么是控制器
8.2.2 Pod 控制器类别
8.3 Pod 副本控制器
8.3.1 ReplicationController(RC)与 ReplicaSet(RS)
8.3.2 YAML 编写示例
(1) ReplicationController
(2) ReplicaSet
8.3.3 matchExpressions 运算符说明
运算符 说明 In label 的值在给定列表中 NotIn label 的值不在给定列表中 Exists label 的 key 存在(不需要 values) DoesNotExist label 的 key 不存在(不需要 values)
8.4 Deployment
8.4.1 Deployment 基本概念
8.4.2 Deployment YAML
8.4.3 Deployment 工作原理
8.4.4 Deployment 原理图示
<!-- 这是一张图片,ocr 内容为: -->
8.4.5 滚动升级原理图示
<!-- 这是一张图片,ocr 内容为: -->
滚动升级过程(假设 replicas=3, maxSurge=1, maxUnavailable=0):
8.4.6 Deployment 清理策略
8.4.7 更新策略详解
8.4.8 金丝雀发布(Canary Deployment)
金丝雀发布是一种降低风险的部署策略: 1. 先部署一个新版本,只让少量流量路由到新版本 2. 验证新版本没有问题 3. 逐步将所有流量切换到新版本 8.5 DaemonSet
8.5.1 DaemonSet YAML
8.5.2 DaemonSet 更新策略
8.6 Job
8.6.1 Job YAML 示例
8.6.2 Job 的三种使用模式
8.7 CronJob
8.7.1 并发策略
8.7.2 CronJob YAML 示例
九、Service
9.1 Service 概念
9.2 kube-proxy 代理模式演进
9.2.1 三种代理模式对比
9.2.2 userspace 模式图示
<!-- 这是一张图片,ocr 内容为: -->
9.2.3 IPVS 模式图示
IPVS 模式工作原理 :kube-proxy 通过 Linux 内核的 IPVS 模块管理转发规则。Service 的 ClusterIP 会被注册到 IPVS 虚拟服务器中,每个后端 Pod 的 IP 作为真实服务器(Real Server)。IPVS 使用高效的内核哈希表进行查找,支持多种负载均衡算法(rr 轮询、lc 最少连接、dh 目标哈希、sh 源哈希等),在高并发场景下性能远优于 iptables。
<!-- 这是一个文本绘图,源码为:graph TB
subgraph "客户端访问"
C[客户端 Pod/Node] -->|"目标: 10.96.1.1:80"| SVC["Service VIP<br>ClusterIP: 10.96.1.1"]
9.2.4 iptables 模式图示
iptables 模式工作原理 :kube-proxy 在 iptables 规则链中写入 NAT 转发规则。每个 Service 对应一条 KUBE-SVC-XXX KUBE-SEP-YYY --probability
<!-- 这是一个文本绘图,源码为:graph LR
subgraph "客户端访问"
C2[客户端 Pod/Node] -->|"目标: 10.96.1.1:80"| SVC2["Service VIP<br>ClusterIP: 10.96.1.1"]
9.3 Service 类型详解
类型 访问范围 说明 ClusterIP 集群内部 默认类型,分配一个集群内部可访问的虚拟 IP NodePort 集群外部 在每台节点上绑定一个端口(30000-32767) LoadBalancer 集群外部 使用云厂商的负载均衡器,自动创建外部 IP ExternalName 集群内部 将外部服务通过 DNS CNAME 映射到集群内部
9.3.1 ClusterIP — 集群内部访问
9.3.2 NodePort — 外部通过节点 IP 访问
9.3.3 LoadBalancer — 云厂商负载均衡器
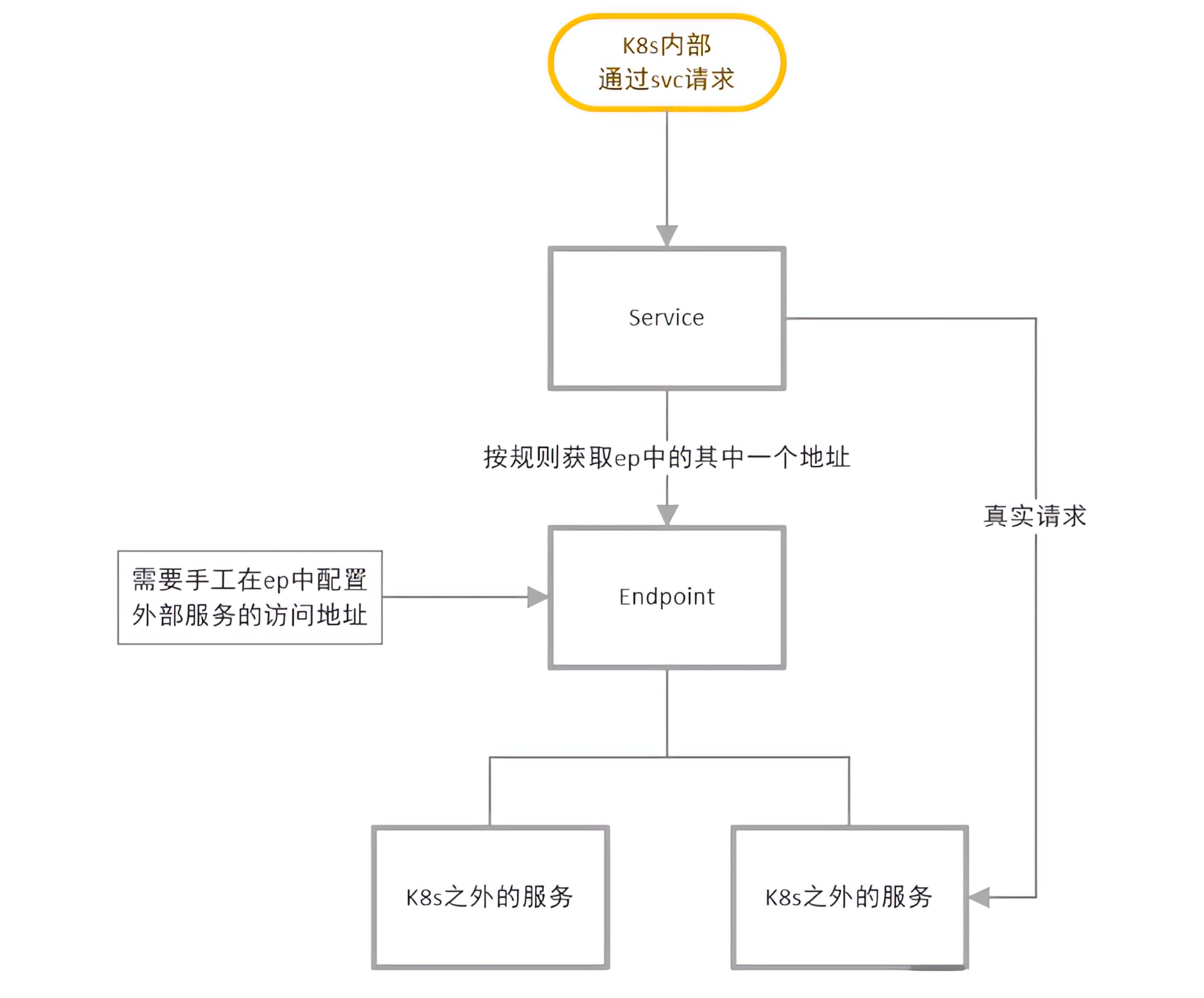
9.3.4 ExternalName — 引入外部服务
9.4 Service YAML 编写
9.4.1 ClusterIP
9.4.2 NodePort
9.4.3 Headless Service(无头服务)
什么是无头服务? 将 Service 的 clusterIP None 不会分配 ClusterIP ,kube-proxy 也不处理该 Service 的负载均衡 。DNS 查询会直接返回所有后端 Pod 的 IP 地址列表 (A 记录),而不是返回一个 ClusterIP。这让客户端可以自行选择连接哪个 Pod,实现自定义的负载均衡或主从拓扑。
(1) 概念对比:ClusterIP vs Headless
普通 ClusterIP Service: DNS 查询 → 返回 ClusterIP(如 10.96.1.1)→ kube-proxy 做 DNAT 转发到 Pod IP (2) 有 Selector 的 Headless Service — 配合 StatefulSet
最经典的用法是 Headless Service + StatefulSet,为每个 Pod 提供稳定的网络标识 。
文件名: mysql-headless.yaml
Headless + StatefulSet 的 DNS 解析结果:
StatefulSet 排序编号的重要性 :某些中间件(如 ZooKeeper、etcd)依赖 Pod 的固定序号来选举 Leader(如 server.0=mysql-0 server.1=mysql-1
(3) 无 Selector 的 Headless Service — 手动管理 Endpoints
如果 selector 集群外部 的服务引入集群内部,或自定义后端选择逻辑。
文件名: external-db-headless.yaml
两种 Headless 方式的对比:
特性 有 Selector 无 Selector DNS A 记录来源 自动从 Pod IP 生成 从手动创建的 Endpoints 读取 Pod 增删 自动更新 DNS 需手动更新 Endpoints 的 addresses 典型用途 StatefulSet、服务发现 将外部服务接入集群 DNS Endpoints 管理 控制器自动维护 手动维护
(4) 使用场景决策
场景 解决方案 原因 数据库主从(读写分离) Headless + StatefulSet 主库 svc-0 svc-1/2 Kafka / ZooKeeper 集群 Headless + StatefulSet 每个 Pod 需要稳定网络标识做集群成员注册 自定义客户端负载均衡 Headless 绕过 kube-proxy,客户端拿到所有 Pod IP 自行决策 连接集群外部已有数据库 Headless(无 selector) 用 DNS 名称替代硬编码 IP,方便迁移
(5) DNS 缓存与 TTL
Headless Service 的 DNS 记录特点: - TTL 默认 30 秒(比普通 Service 短) - Pod 下线时,DNS 记录会快速移除(约 30 秒内) - 应用程序如果缓存 DNS 结果,可能导致连接旧 Pod IP 失败 - 建议:客户端应用尝试连接失败后,重新做 DNS 查询 (6) 调试 Headless Service
9.5 Service 图示
9.5.1 ClusterIP 图示
<!-- 这是一张图片,ocr 内容为: -->
9.5.2 NodePort 图示
<!-- 这是一张图片,ocr 内容为: -->
9.5.3 LoadBalancer 图示
<!-- 这是一张图片,ocr 内容为: -->
9.5.4 ExternalName 图示
集群内部访问:external-db.default.svc.cluster.local ↓(DNS CNAME 解析) 外部地址:mydb.rds.amazonaws.com:3306 十、Endpoint
10.1 概念
10.2 Endpoint 与 Service 的关联
10.2.1 关联图示
<!-- 这是一张图片,ocr 内容为: -->
10.2.2 两种关联模式
(1) 自动关联体系(配置 selector)
Service 配置了 selector → K8s 自动创建和管理 Endpoints - 自动发现匹配的 Pod - Pod 就绪时自动加入 Endpoints - Pod 终止/不健康时自动从 Endpoints 移除
<!-- 这是一张图片,ocr 内容为: -->
(2) 手动关联体系(无 selector)
Service 不配置 selector → 需要手动创建 Endpoints - 适用于对接集群外部服务 - 需要手动维护 Endpoints 中的 IP 列表 - Service 和 Endpoints 必须同名
<!-- 这是一张图片,ocr 内容为: -->
10.3 Endpoints YAML
10.4 注意事项
1. Endpoint 的 metadata.name 必须与对应 Service 的名称完全一致 2. Endpoint 中 port 的 name 必须与 Service 中 port 的 name 保持一致 3. 手动模式下,如果 Endpoints 没有对应端点,Service 将无法工作 4. 自动模式下,如果所有后端 Pod 都未就绪,Endpoints 将为空的子集 5. EndpointSlice(K8s v1.21+)是 Endpoints 的替代方案,支持更大规模 10.5 publishNotReadyAddresses
十一、K8s 存储
11.1 存储分类
11.2 ConfigMap
11.2.1 概念
11.2.2 ConfigMap 创建方式
(1) 命令式创建
(2) 声明式创建(YAML)
11.2.3 将 ConfigMap 挂载为文件(Volume 挂载)
(1) 基础挂载 — 整个 ConfigMap 挂载为目录
每个 key 成为挂载目录下的一个文件,文件名为 key 名,文件内容为 value。
文件名: pod-nginx-configmap.yaml
基础挂载的行为特点 :ConfigMap 的所有 key 都会以独立文件形式出现在挂载目录中。如果挂载目录原本有其他文件,这些文件会被覆盖隐藏 ,目录中只能看到 ConfigMap 的文件。
(2) items 过滤 + keyToPath — 选择性挂载并重命名
通过 items keyToPath
字段 作用 示例 items[].key ConfigMap 中的原始 key 名 nginx.conf items[].path 挂载后的文件名或子路径 default.conf
效果 :挂载后 /etc/nginx/conf.d/ default.conf vhost.conf
效果 :挂载后目录结构为:
items[].path /
/app/configs/ ├── database/ │ └── db.yaml (权限 0644) └── cache/ └── redis.yaml (权限 0600) (3) subPath 挂载 — 挂载单个文件到已有目录
subPath items + keyToPath
特性 普通卷挂载 subPath 挂载 挂载方式 整个目录被 ConfigMap 覆盖 只替换单个文件,不覆盖目录 目录中原有文件 被隐藏 保留 ConfigMap 热更新 支持(有延迟) 不支持 典型场景 配置目录完全由 ConfigMap 管理 在已有配置目录中覆盖某一个文件
subPath 重要限制 :
使用 subPath 不支持 ConfigMap 热更新 。修改 ConfigMap 后,容器内的文件不会自动更新
如果容器镜像中该路径已有文件,subPath
适合覆盖镜像内已有的某个配置文件(如 /etc/nginx/nginx.conf
(4) subPathExpr — 基于环境变量的动态子路径
subPathExpr subPath
效果 :当 APP_ENV=production production/nginx.conf
subPathExpr 限制 :同样不支持热更新 。
(5) defaultMode — 控制挂载文件和目录的默认权限
权限说明 :
defaultMode 0644 items[].mode defaultMode 数字必须是八进制表示(0400
挂载方式对比总结
挂载方式 热更新 覆盖目录 适用场景 整个 ConfigMap 挂载为目录 支持 是 配置目录完全由 ConfigMap 管理 items + keyToPath 选择/重命名 支持 是 只暴露部分 key,控制文件名和目录结构 subPath 挂载单个文件 不支持 否 在已有配置目录中覆盖一个文件,保留其他文件 subPathExpr 动态路径 不支持 否 根据环境变量选择不同配置文件
热更新注意事项 :
挂载为 Volume(非 subPath)的文件会在 ConfigMap 更新后通过 kubelet 同步周期(默认约 1 分钟)自动更新到 Pod 内
但应用程序不会自动重载配置,需要配合 inotify Reloader
环境变量注入的值永远不会热更新 ,只有重启 Pod 才会生效
11.2.5 不可变 ConfigMap
11.3 Secret
11.3.1 Secret 概念
11.3.2 Secret 创建
11.3.3 Secret YAML
11.3.4 Pod 中使用 Secret
11.4 Volume(普通卷)
11.4.1 Volume 概念
11.4.2 emptyDir
11.4.3 emptyDir YAML
11.4.4 hostPath
十二、PV 和 PVC(持久卷)
12.1 基本概念
12.2 PV 与 PVC 绑定条件
12.3 PV 回收策略(PersistentVolumeReclaimPolicy)
策略 行为 说明 Retain(保留) 手动回收 PVC 删除后 PV 保留,数据保留,需要管理员手动清理 Recycle(回收) 基本擦除 执行 rm -rf /thevolume/*,已被弃用 Delete(删除) 自动删除 PVC 删除时,PV 和底层存储一起删除
支持的存储类型: - Retain:所有类型都支持 - Recycle:仅 NFS 和 HostPath 支持(已弃用) - Delete:AWS EBS、GCE PD、Azure Disk、Cinder 等支持 12.4 PV 状态转换
状态转换流程: [创建 PV] → Available → [被 PVC 绑定] → Bound → [PVC 被删除] → Released → [回收] → Available → [回收失败] → Failed 12.5 PV YAML 示例
12.6 StorageClass(动态供应)
十三、调度策略
13.1 污点与容忍(Taint 和 Toleration)
13.1.1 概念
13.1.2 污点组成
13.1.3 污点操作
13.1.4 容忍设置
13.1.5 多 Master 调度优化
13.2 节点选择与亲和性
13.2.1 nodeName(强制调度到指定节点)
13.2.2 nodeSelector(节点标签选择器)
13.2.3 nodeAffinity(节点亲和性)
13.2.4 Pod 亲和性与反亲和性
十四、K8s 集群安全机制
14.1 安全机制概述
14.2 认证方式(Authentication)
14.2.1 kubeconfig 文件
kubeconfig 包含三个部分: 14.3 RBAC(基于角色的访问控制)
14.3.1 RBAC 核心概念
14.3.2 用户来源
K8s 集群中有两种用户: 1. 普通用户(Normal User):由外部服务管理(证书、OIDC 等) 14.3.3 Role 和 RoleBinding YAML
14.3.4 ServiceAccount
YAML 文件方式(推荐)
文件名: rbac/sa-myapp.yaml
# 应用 YAML 文件 kubectl apply -f rbac/sa-myapp.yaml 命令行方式
14.3.5 创建 K8s 访问 Token(重要:区分 1.24 版本)
关键变化 :Kubernetes v1.24 开始,创建 ServiceAccount 时不再自动创建 对应的 Secret(kubernetes.io/service-account-token
Token 创建方式选择(按版本区分):
v1.24 及以上
优先使用:kubectl create token
备选方案:手动创建 Secret 并绑定 ServiceAccount 注解
v1.23 及以下
创建 ServiceAccount 时自动生成 Secret
也支持手动创建 Secret 并指定 ServiceAccount
获取 Token 后如何获得 kubeconfig → 见 14.3.6 Token 转 kubeconfig 完整步骤
一、YAML 文件方式(推荐生产环境使用)
说明 :将 SA、Role、RoleBinding、Secret 写在一个 YAML 文件中,多个资源用 --- kubectl apply
(1) v1.24 及以上 — YAML 文件方式
文件名: rbac/cicd-deployer.yaml
v1.24+ 注意事项 :
Secret 必须带有 kubernetes.io/service-account.name
TokenController 检测到注解后会自动注入 token ca.crt namespace
删除 SA 时,手动创建的 Secret 不会自动删除,需单独清理
(2) v1.23 及以下 — YAML 文件方式
文件名: rbac/prod-deployer.yaml
(3) v1.23 及以下 — 选择手动创建 Secret 而不用自动创建的
如果不想使用自动生成的 Secret,也可以像 v1.24+ 一样手动创建:
文件名: rbac/prod-deployer-manual-token.yaml
何时需要手动指定 Secret 名称? 自动生成的名称带有随机后缀(-xxxxx
二、命令行方式(适合快速测试)
说明 :使用 kubectl create
(4) v1.24 及以上 — 命令行方式
v1.24+ 命令行方式需要手动 Secret 怎么办? 如果希望 Token 持久化为 Secret 资源便于查看,用上面的 YAML 文件方式 (1) 来创建 Secret。命令行方式的 kubectl create token
(5) v1.23 及以下 — 命令行方式
版本区别对比总结
特性 v1.23 及以下 v1.24 及以上 SA 创建时自动创建 Secret 是(自动) 否(需手动) 推荐获取 Token 方式 读取自动生成的 Secret kubectl create token Token 是否持久化为 Secret 是 否(TokenRequest API 签发) Secret 需要注解绑定 SA 自动创建不需要 手动创建必需 安全性 Token 长期有效 时间限制 Token,安全性更高 YAML 文件推荐方式 SA + Role + RoleBinding SA + Role + RoleBinding + Secret
14.3.6 Token 生成 kubeconfig(所有版本通用)
拿到 Token 后,生成独立的 kubeconfig 文件给 CI/CD 或开发者使用:
文件名: scripts/gen-kubeconfig.sh
安全建议 :
优先使用 v1.24+ 的 kubectl create token --duration
Token 不要硬编码到代码仓库中,使用 CI/CD Secret 变量或 HashiCorp Vault 管理
遵循最小权限原则,SA 只授予必要的最小 API 权限
为每个自动化工具创建独立的 ServiceAccount,不要共享
定期审计 ServiceAccount 和 RoleBinding 列表
推荐将生成的 kubeconfig 脚本化(如上面的 gen-kubeconfig.sh
十五、Ingress
15.1 Ingress 概念
15.2 Ingress YAML
15.3 Ingress Controller 安装
十六、资源管理
16.1 资源请求与限制
16.1.1 资源单位说明
16.2 HPA(水平 Pod 自动伸缩)
16.3 ResourceQuota(资源配额)
16.4 LimitRange(限制范围)
十七、常用运维命令速查
十八、K8s API 扩展与 CRD
18.1 什么是 CRD
CRD(Custom Resource Definition,自定义资源定义) 是 Kubernetes 提供的 API 扩展机制。它允许你向 K8s API 中注册自定义资源类型 ,然后像操作原生资源(Pod、Service、Deployment)一样,用 kubectl
K8s 中资源类型的三种来源:
内置资源(Built-in Resources)
Pod、Service、Deployment、ConfigMap、Secret、PVC 等
K8s 核心代码直接定义,随版本发布
聚合 API(Aggregated API)
通过 API Server 的 Extension API Server 注册
需要额外运行独立服务(如 metrics-server)
实现复杂,适合需要完整 API 逻辑的场景
CRD(Custom Resource Definition) 本章重点
声明式定义,一个 YAML 即可创建新资源类型
资源自动注册到 API Server,获得完整的 K8s API 能力
配合 Controller 形成 Operator 模式(见第十九章)
为什么需要 CRD?
CRD 在整个 K8s 生态中的位置
数据流路径:kubectl → API Server → Controller/Operator
kubectl / API 客户端
发起 HTTP REST 请求(kubectl apply/get/edit
API Server(kube-apiserver)
根据 API 路由表将请求分发到对应的资源处理器:
/api/v1/pods /apis/apps/v1/deployments /apis/cache.example.com/v1/redisclusters CRD 注册的自定义资源
Controller / Operator(自定义逻辑)
通过 Watch 机制监听到 CR 的 Add / Update / Delete 事件
触发 Reconcile 循环:
对比实际状态 vs 期望状态
执行操作,让实际状态趋向期望状态
18.2 CRD 完整 YAML 定义详解
(1) CR 与 CRD 的关系
CRD(Custom Resource Definition) → 定义"资源类型是什么样子的"(相当于建表 DDL) CR(Custom Resource) → 该类型的一个具体实例(相当于 INSERT 数据)
类比理解:CREATE TABLE 语句 : 一张表的数据行 = CRD : CR
CRD 定义资源的结构(schema)、名称(kind/group)、作用域(scope),CR 则是用户创建的实际数据。
(2) CRD 完整定义示例
文件名: crd/rediscluster-crd.yaml
CRD 注册后发生了什么?
API Server 在内存中为该资源类型创建路由映射
etcd 中会存储 CRD 定义本身(/registry/customresourcedefinitions/redisclusters.cache.example.com
用户创建的 CR 数据存储在 /registry/cache.example.com/redisclusters/<namespace>/<name>
kubectl api-resources kubectl explain
18.3 创建和使用自定义资源(CR)
(1) 创建第一个 CR
文件名: cr/my-redis.yaml
重要提示 :此时只是创建了数据!因为没有对应的 Controller/Operator,status
(2) 字段校验测试
18.4 CRD 关键特性详解
(1) 多版本支持
当 CRD 需要演进时(比如 v1alpha1 → v1beta1 → v1),可以定义多个版本共存:
CRD 版本转换流程(conversion: Webhook)
存储版本 始终为 v1(由 spec.versions[].storage: true
用户创建 v1 版本 CR → API Server 将 v1 格式数据存储到 etcd用户用 v1alpha1 API 路径查询 :API Server 从 etcd 读取 v1 数据 → 发送到 Webhook 服务转换为 v1alpha1 格式 → 返回 v1alpha1 格式给用户用户用 v1alpha1 创建/更新 :请求发送到 Webhook 服务转换为 v1 格式 → 将转换后的 v1 存入 etcd
版本退役流程 :
不推荐(Deprecated):标记 deprecated: true deprecationWarning
停止服务(Removal):served: false
仅删除 CRD 时才会清除所有版本的数据
(2) Finalizer 机制
Finalizer 是一个预删除钩子,CR 被删除时在 Finalizer 被清理前不会真正从 etcd 删除 。
Finalizer 执行流程:
kubectl delete rediscluster my-redis API Server 检测到 finalizers
设置 metadata.deletionTimestamp
设置 metadata.deletionGracePeriodSeconds
Operator 监听到
典型用途 :
清理外部资源:删除云负载均衡器、释放云硬盘、注销 DNS 记录
数据备份:删除前备份数据到 S3
级联操作:确保子资源先于父资源删除(foregroundDeletion orphan
18.5 其他常用 CRD 资源介绍
K8s 生态中许多知名项目都是通过 CRD 来扩展 K8s API 的:
项目 CRD Kind 用途 cert-manager Certificate Issuer ClusterIssuer 自动管理 TLS 证书(ACME/Let's Encrypt) Prometheus Operator Prometheus
十九、Operator 模式
19.1 什么是 Operator
Operator = CRD(自定义资源)+ Controller(控制器) 。Operator 将人类运维知识编码为软件,自动管理有状态应用的生命周期。
Operator 的直观理解:
传统运维 :人 → 看到告警 "Redis 主节点挂了" → SSH 登录 → 手动执行 failoverOperator 运维 :人 → 提交 RedisCluster CR (replicas: 3) → Operator 自动创建 Pod/PVC/Service → 监控健康 → 自动故障转移Operator 本质上 是 "一个具备领域知识(Domain Knowledge)的 K8s 控制器",比如 Redis Operator 知道如何引导 Redis Sentinel、如何执行 failover
Operator 模式由 CoreOS(后被 Red Hat 收购)在 2016 年提出 ,目的是解决有状态应用(数据库、消息队列、监控系统)在 K8s 上的管理难题。无状态应用(如 Web 服务)可以用原生 Deployment 管理,但有状态应用需要关心拓扑结构、主从关系、数据持久化、备份恢复 等复杂逻辑。
19.2 Reconcile 控制循环(核心概念)
Operator 的核心是 Reconcile 循环(调谐循环) ,这是一个无限循环,不断对比期望状态 和实际状态 ,并让实际状态趋向期望状态。
Reconcile 循环的 7 个步骤:
监听到 CR 变化事件 (Add / Update / Delete)读取 CR Spec → 获取用户期望的状态观察集群实际状态 (Observe)→ 当前 Pod 数量、健康状态等对比期望 vs 实际 (Diff)
无差异 → 跳过后续步骤,等待下一次事件有差异 → 继续执行步骤 5
执行动作让实际→期望 (Reconcile / Act)→ 创建/更新/删除子资源更新 CR Status → 记录 phase / conditions 到 CR 的 status 字段等待下一次事件 → Watch CR + 子资源变化,或定时 Requeue
调谐(Reconcile)这个名字的由来 :就像一个不断自动校准的恒温器——设定温度 25°C(期望状态),检测到当前 22°C(实际状态),打开暖气加热(执行动作)。下次再检测,如果超过 25°C 就关掉暖气。Operator 做的事情完全一样,但管理的是 Pod、PVC、Service 等资源。
19.3 Operator 的设计原则
(1) 声明式优于命令式
方式 思想 示例 命令式 告诉系统怎么做 "创建 3 个 Pod,配置主从,打开端口" 声明式 告诉系统要什么结果 "我要一个 3 副本的 Redis 7.0 集群"
声明式的优势:用户只需描述想要的状态 ,Operator 负责理解如何达成 。Operator 可以在实现方式改变时(如换用 Redis Cluster 代替 Sentinel)对用户完全透明。
(2) 控制循环必须是幂等的
Reconcile 函数可能被重复调用(网络重试、重启、定时触发),相同输入必须产生相同结果 ,不会因为重复执行而出错或产生副作用。
第 1 次 Reconcile:发现缺少 Pod → 创建 Pod → 更新 Status 第 2 次 Reconcile:发现 Pod 已存在且运行正常 → 无需操作 → 返回(不创建第二个 Pod) (3) 一个 Operator 管理一个应用类型
推荐:Redis Operator → 只管理 Redis;PostgreSQL Operator → 只管理 PostgreSQL;Kafka Operator → 只管理 Kafka
不推荐:Mega Operator → 管理 Redis + PostgreSQL + Kafka + Elasticsearch
19.4 Operator 成熟度模型
Operator SDK 定义了 5 个能力级别,帮助评估和管理 Operator 的复杂度:
级别 名称 能力描述 典型场景 Level 1 基础安装(Basic Install) 声明式创建应用(CR → Deployment/Service);自动配置(ConfigMap、Secret)。适合无状态或有状态简单的应用 Nginx Operator、简单 Redis Operator Level 2 无缝升级(Seamless Upgrades) 应用版本升级(滚动升级、金丝雀升级);版本变更时的数据迁移 更新 CR 的 spec.version 实现平滑升级 Level 3 全生命周期(Full Lifecycle) 数据备份、恢复;故障转移、自动 rebalance;扩缩容 Redis Sentinel failover、PostgreSQL 主从切换 Level 4 深度洞察(Deep Insights) 应用层 Prometheus metrics;告警和日志集成;通过 ServiceMonitor / PrometheusRule 自动配置监控 - Level 5 全自动运维(Auto Pilot) 自动扩缩容(基于负载/时间/预测);自动调优(按 workload 调整参数);自动修复(故障预测 + 提前干预) ClickHouse Operator 自动分区策略优化
19.5 编写 Operator 的工具链
(1) 工具对比
工具 抽象级别 语言 适合场景 controller-runtime 底层框架 Go 完全自定义,灵活度最高 Kubebuilder 脚手架(基于 controller-runtime) Go 官方推荐,快速生成 CRD + Controller 骨架 Operator SDK 脚手架(基于 controller-runtime + Ansible/Helm) Go/Ansible/Helm Red Hat 维护,支持更多上层抽象 kopf 轻量框架 Python Python 技术栈团队 Metacontroller Lambda 式框架 任意语言 通过 Webhook 回调实现,语言无关
(2) Kubebuilder 快速创建 Operator 流程
19.6 Reconcile 函数核心逻辑示例
以下是一个简化的 RedisCluster Controller 的 Reconcile 函数骨架,展示核心思路:
关键理解点 :
Reconcile req.NamespacedName 所有 Get Create Update
19.7 RBAC 标记与安全
Controller 需要和它管理的资源一样经过 RBAC 授权。Kubebuilder 通过代码注解自动生成 ClusterRole:
19.8 Operator 与普通控制器的区别
维度 普通 Controller(如 Deployment Controller) Operator 管理对象 无状态工作负载(Pod) 有状态应用(数据库、消息队列) 领域知识 通用调度逻辑(副本数、滚动更新) 应用专有知识(主从选举、数据迁移) 决策依据 Pod 数量、健康检查结果 应用层指标(同步延迟、主从角色) CRD 不需要(用内置资源) 需要(定义应用特定的配置) 自动修复 Pod 挂了 → 重新创建 主节点挂了 → 选举新主 → 重定向流量 → 通知客户端 示例 Deployment、StatefulSet、DaemonSet etcd Operator、Prometheus Operator、PostgreSQL Operator
19.9 推荐的开源 Operator
Operator 管理的应用 特点 prometheus-operator Prometheus + AlertManager + Grafana K8s 监控事实标准,通过 ServiceMonitor 自动发现 strimzi-kafka-operator Apache Kafka 功能最完整的 Kafka Operator,支持 Connect/MirrorMaker zalando-postgres-operator PostgreSQL 支持流复制、时间点恢复、自动故障转移 rabbitmq-cluster-operator RabbitMQ 官方 Operator,支持集群和镜像队列 cert-manager TLS 证书 自动管理和续期 Let's Encrypt 证书 sealed-secrets Secret 加密 安全将 Secret 存入 Git,集群内自动解密 victoria-metrics-operator VictoriaMetrics 监控数据存储,Prometheus 兼容 elastic-operator (ECK) Elasticsearch + Kibana 完整 ELK 栈集群管理 tidb-operator TiDB 国产分布式数据库的 Operator 参考实现 istio-operator Istio 服务网格 声明式管理 Istio 控制面
官方资源 :
核心特征:
- 用户只需管理应用代码和数据
- 云厂商负责操作系统、中间件、运行时
- 典型产品:Google App Engine、Heroku、Cloud Foundry
- Kubernetes 本身就是 PaaS 理念的最佳实践载体
1. 服务发现和负载均衡 K8s 可以为容器提供自己的 IP 地址和 DNS 名称,并能在多个容器之间负载均衡流量。
2. 存储编排 自动挂载所选的存储系统,无论是本地存储、公共云提供商(AWS EBS、GCE PD)还是网络存储(NFS、Ceph、GlusterFS)。
3. 自动部署和回滚 描述期望状态后,K8s 以受控速率将实际状态更改为期望状态。支持滚动更新、蓝绿部署、金丝雀发布。
4. 自动分配 CPU/内存资源 — 弹性伸缩 通过 HPA(水平 Pod 自动伸缩器)根据 CPU 使用率或自定义指标自动扩缩容。
5. 自我修复 重新启动失败的容器、替换被杀死或无响应的容器、在节点故障时重新调度 Pod。
6. Secret 和配置管理 部署和更新 Secret(密码、令牌、密钥)和 ConfigMap(应用程序配置),无需重建容器镜像。
7. 大规模支持 单个集群可管理数千节点和数万 Pod。
8. 开源生态 庞大的 CNCF 生态:Helm、Prometheus、Istio、ArgoCD、Tekton 等。
// Kubernetes 官方推荐的单个集群规模上限 每个节点的 Pod 数量不超过 110 节点数不超过 5000 Pod 总数不超过 150000 容器总数不超过 300000
Borg(2003) > Omega(2013) > Kubernetes(2014)
Borg: - Google 早期开发的集群管理系统,自 2003 年开始内部使用 - 负责调度、作业类型管理、资源分配、故障隔离 - 奠定了容器化编排的理论基础
Omega: - Borg 的后继系统,2013 年开始开发 - 引入多租户支持、声明式配置、乐观并发控制 - 解决了 Borg 在大规模、动态、多租户环境下的调度瓶颈
Kubernetes: - 吸取 Borg 和 Omega 的经验教训,2014 年 6 月开源 - 2015 年发布 1.0 版本,捐赠给 CNCF - 已成为容器编排领域的事实标准
控制平面组件管理集群的整体状态,负责全局决策和事件响应。
1. kube-apiserver - 公开 Kubernetes HTTP API 的核心组件服务器 - 所有组件通信的统一入口 - 支持 RESTful API、认证、授权、准入控制 - 默认端口:6443(安全端口) - 水平可扩展(前面可加负载均衡器)
2. etcd - 具备一致性和高可用性的键值存储数据库 - 用于存储所有 API 服务器的数据(集群状态、配置、元数据) - 基于 Raft 共识算法实现强一致性 - 默认端口:2379(客户端)、2380(节点间通信) - 建议使用奇数节点(3/5/7)部署,生产环境至少 3 节点
3. kube-scheduler - 查找尚未绑定到节点的 Pod,并将每个 Pod 分配给合适的节点 - 调度过程分为:过滤(Filtering)和打分(Scoring)两个阶段 - 考虑因素:资源需求/限制、亲和性/反亲和性、污点容忍、数据局部性 - 支持自定义调度器和调度扩展
4. kube-controller-manager - 运行一系列控制器来实现 Kubernetes API 行为 - 主要控制器包括: * Node Controller:监控节点健康状态 * Replication Controller:维护 Pod 副本数 * Endpoints Controller:填充 Endpoints 对象 * Service Account Controller:为命名空间创建默认 ServiceAccount * 以及 Namespace、Job、DaemonSet、StatefulSet 等控制器 - 所有控制器编译进同一个二进制,以单一进程运行
5. cloud-controller-manager(可选) - 与底层云驱动集成,将集群连接到云提供商 API - Node Controller:检查云提供商节点是否已删除 - Route Controller:设置云提供商底层路由 - Service Controller:创建/更新/删除云提供商负载均衡器
在每个节点上运行,维护运行的 Pod 并提供 Kubernetes 运行时环境:
1. kubelet - 确保 Pod 及其容器正常运行 - 接收 PodSpecs(来自 apiserver 或本地文件),确保其中描述的容器运行且健康 - 通过 CRI(容器运行时接口)与容器运行时通信 - 报告节点状态和 Pod 状态给控制平面 - 启动静态 Pod(由本地文件定义,不受 apiserver 管理)
2. kube-proxy - 维护节点上的网络规则以实现 Service 的功能 - 支持三种代理模式: * userspace(已弃用):最古老模式,延迟高 * iptables(默认):基于 Linux iptables 规则,性能好但规则量大时有性能问题 * IPVS(推荐):基于 Linux IPVS,支持多种负载均衡算法 - 实现 Service 到 Pod 的流量转发
3. 容器运行时(Container Runtime) - 负责运行容器的软件 - 通过 CRI 接口与 kubelet 通信 - 支持:containerd(推荐)、CRI-O、Docker Engine(通过 cri-dockerd 适配器) - 注意:Kubernetes v1.24 起移除了 dockershim,官方推荐 containerd
API -->|读写| ETCD[etcd 集群] API -->|Watch 未调度Pod| SCH[kube-scheduler] SCH -->|绑定 Pod 到 Node| API API -->|Watch 已绑定Pod| KUBELET[kubelet] KUBELET -->|CRI 调用| CR[Container Runtime] API -->|Watch Service/Endpoint| PROXY[kube-proxy] PROXY -->|更新规则| IPT[iptables/IPVS] -->
Pod 是 Kubernetes 的最小部署单位,是一种容器组。一个 Pod 可以包含一个或多个紧密耦合的容器。
Pause 容器(Infra Container): - Pod 内部第一个启动的容器(对用户透明) - 初始化网络命名空间(Network Namespace) - 挂载需要的存储卷 - 回收僵尸进程(相当于操作系统的 1 号进程) - 为 Pod 内其他容器提供共享的命名空间支撑
同一个 Pod 内共享的内容: - Network 命名空间:共享 IP 地址和端口空间 - PID 命名空间:可以看到彼此的进程 - IPC 命名空间:可以通过 System V IPC 或 POSIX 消息队列通信 - 存储卷(Volume):可以挂载相同的卷
共享的实用意义: - 网络共享:容器间可通过 localhost(127.0.0.1)相互调用 - 文件共享:使用共享卷进行数据交换 - 紧密协作:适合 Sidecar 模式(如日志收集、配置热更新代理)
何时使用多容器 Pod: 1. Sidecar 模式 - 主容器 + 辅助容器(日志收集、监控、代理) - 示例:Nginx + Filebeat 日志收集
2. Ambassador 模式 - 主容器 + 代理容器(代理外部服务) - 示例:应用容器 + 数据库代理
3. Adapter 模式 - 主容器 + 适配器容器(统一监控/日志格式) - 示例:应用容器 + Prometheus Exporter
何时使用单容器 Pod: - 大多数场景下,一个 Pod 只运行一个应用容器即可 - 不要仅仅为了"放在一起"而使用多容器 Pod
我们需要自己实现这个网络假设,将不同节点上的容器之间的互相访问先打通,然后运行 Kubernetes。
这就需要 CNI(容器网络接口)网络插件来实现。
第一层:容器内通信 - 同一 Pod 内容器通过 localhost + 端口通信(共享 Network Namespace)
第二层:同节点 Pod 间通信 - 通过虚拟网桥(cni0 / docker0)转发,不走物理网络
第三层:跨节点 Pod 间通信 - 通过 CNI 插件封包/解包(Overlay: VXLAN/IPIP)或路由(BGP)
第四层:Pod 与 Service 通信 - 通过 kube-proxy 维护的 iptables/IPVS 规则转发到目标 Pod
Kubernetes 集群内置 DNS 服务器(CoreDNS),为 Service 和 Pod 提供 DNS 解析:
Service DNS 格式: <service-name>.<namespace>.svc.cluster.local
示例: nginx-service.default.svc.cluster.local → 解析到 Service 的 ClusterIP
Pod DNS 格式: <pod-ip-with-dashes>.<namespace>.pod.cluster.local
示例: 10-244-1-5.default.pod.cluster.local → 解析到 Pod IP
注意:Pod 的 DNS 策略可通过 dnsPolicy 配置(Default、ClusterFirst、ClusterFirstWithHostNet、None)
名称空间级别(Namespaced): 1. 工作负载型资源:Pod、ReplicaSet、Deployment、StatefulSet、DaemonSet、Job、CronJob 2. 服务发现及负载均衡型资源:Service、Ingress、NetworkPolicy 3. 配置与存储资源:Volume、PersistentVolumeClaim、ConfigMap、Secret 4. 特殊类型的存储卷:ConfigMap、Secret、DownwardAPI
集群级资源(Cluster-scoped): 1. Namespace、Node、PersistentVolume 2. ClusterRole、ClusterRoleBinding 3. StorageClass
元数据类型: 1. HPA(HorizontalPodAutoscaler)、PodTemplate、LimitRange、ResourceQuota 2. PodDisruptionBudget、PriorityClass
apiVersion : v1 # API 组/版本(必填) kind : Pod # 资源类别(必填) metadata : # 元数据(必填) name : pod-demo # 资源名称 namespace : default # 命名空间 labels : # 标签(用于选择器和分组) app : myapp version : v1 annotations : # 注解(用于存储非标识信息) description : "这是一个示例 Pod" spec : # 期望规格(必填) containers : - name : myapp-1 image : yangjunlinux/myapp:v1.0 ports : - containerPort : 80 name : http - name : busybox-1 image : yangjunlinux/tools:busybox command : - "/bin/sh" - "-c" - "sleep 3600" status : # 当前状态(由系统维护,只读) conditions : - lastProbeTime : null lastTransitionTime : "2023-11-21T08:49:07Z" status : "True" type : Initialized ...
# ==================== 集群信息 ==================== # 查看集群信息 kubectl cluster-info
# 查看所有 API 资源 kubectl api-resources
# 查看支持的 API 版本 kubectl api-versions
# 查看节点 kubectl get nodes -o wide kubectl describe node < node-nam e>
# ==================== Pod 操作 ==================== # 实时查看集群所有 Pod 的状态 kubectl get pods -A -o wide
# 监视 Pod 变化 kubectl get pods -w
# 显示标签信息 kubectl get pod --show-labels
# 按标签筛选 kubectl get pod -l app=myapp kubectl get pod -l 'app in (myapp,nginx),tier=frontend'
# 查看 Pod 详情 kubectl describe pod < pod-nam e>
# 进入 Pod 中容器内部 kubectl exec -it < pod-nam e> -c < container-nam e> -- /bin/bash kubectl exec -it < pod-nam e> -- /bin/sh
# 查看 Pod 日志 kubectl logs < pod-nam e> -c < container-nam e> # 当前日志 kubectl logs < pod-nam e> --tail=100 # 最后100行 kubectl logs < pod-nam e> -f # 实时跟踪 kubectl logs < pod-nam e> --since=1h # 最近1小时 kubectl logs < pod-nam e> --previous # 上一个容器实例日志
# 查看资源清单详细说明 kubectl explain pod kubectl explain pod.spec.containers kubectl explain pod.spec.containers.livenessProbe --recursive
# 导出 YAML kubectl get pod < pod-nam e> -o yaml > pod-backup.yaml kubectl get pod < pod-nam e> -o json # JSON 格式 kubectl get pod < pod-nam e> -o wide # 详细信息 kubectl get pod < pod-nam e> -o custom-columns=NAME:.metadata.name,IP:.status.podIP
# ==================== 端口转发 ==================== # 将本地端口转发到 Pod 端口(调试用) kubectl port-forward pod/ < pod-nam e> 8080:80 kubectl port-forward svc/ < service-nam e> 8080:80 -n < namespac e>
kubectl get pod [podName] [选项]
选项说明: -A, --all-namespaces 查看当前所有命名空间的资源 -n < namespac e> 指定命名空间,默认值 default 注意:kube-system 命名空间存放的是集群组件资源 --show-labels 查看当前资源的所有标签 -l < selecto r> 按标签筛选资源 格式:key =value、key!=value、key in (v1,v2) -o wide 详细信息,包括 Pod IP、分配的节点 -o yaml / -o json 以 YAML/JSON 格式输出完整对象 -w, --watch 监视资源变化(实时刷新)
# 示例 kubectl get pod -n kube-system -o wide kubectl get pod -l 'app=nginx,tier=frontend' --show-labels kubectl get pod -A -o custom-columns=NAMESPACE:.metadata.namespace,NAME:.metadata.name,IP:.status.podIP,NODE:.spec.nodeName
kubectl exec [选项] <podName> [-c < containerName > ] -- <command>
选项说明: -c, --container 指定容器名(多容器 Pod 时需要) -i, --stdin 将标准输入传入容器 -t, --tty 分配一个伪终端 -- 分隔符(后面是容器内要执行的命令)
# 示例 kubectl exec -it nginx-pod -- /bin/bash # 进入默认容器 kubectl exec -it nginx-pod -c sidecar -- /bin/sh # 进入指定容器 kubectl exec nginx-pod -- ls /usr/share/nginx/html # 执行单条命令 kubectl exec nginx-pod -- nginx -s reload # 热重载 Nginx kubectl exec -it mysql-pod -- mysql -u root -p # 连数据库
# 查看字段说明 kubectl explain pod kubectl explain pod.spec kubectl explain pod.spec.containers kubectl explain pod.spec.containers.resources
# 递归显示所有字段 kubectl explain pod --recursive kubectl explain deployment.spec.strategy.rollingUpdate --recursive
kubectl logs < podNam e> [选项]
选项说明: -c, --container 指定容器名 -f, --follow 实时跟踪日志输出 --tail = < n > 显示最后 n 行 --since = < duration > 显示最近时间段内的日志,如 --since=1h --timestamps 显示时间戳 --previous, -p 显示上一个终止容器的日志(调试 CrashLoopBackOff 时很有用)
# 示例 kubectl logs nginx-pod -c nginx --tail=100 -f kubectl logs nginx-pod --since=30m --timestamps kubectl logs nginx-pod --previous # 查看崩溃前的日志
kubectl describe pod < podNam e> [-n < namespac e> ]
# 会显示: # - 基本信息:Name、Namespace、Node、IP # - 标签和注解 # - 容器状态:State(Running/Waiting/Terminated)、RestartCount # - 事件(Events):记录 Pod 整个生命周期的事件 # 如:Scheduled、Pulled、Created、Started、Unhealthy、Killing 等
kubectl delete < kin d> < objNam e> [选项]
选项说明: --all 删除当前命名空间下该类型的所有对象 -l < selecto r> 按标签选择器删除 --grace-period = < 秒 > 优雅终止等待时间(默认 30 秒) --force 强制删除(跳过优雅终止) -n < namespac e> 指定命名空间 --cascade = 'foreground' 级联删除依赖资源(默认)
# 示例 kubectl delete pod nginx-pod kubectl delete pod --all -n dev # 删除 dev 命名空间所有 Pod kubectl delete pod -l app=nginx # 按标签删除 kubectl delete pod nginx-pod --grace-period=0 --force # 强制立即删除 kubectl delete deployment,service -l app=myapp # 同时删除多种资源
# 根据文件删除 kubectl delete -f deployment.yaml
# 1) 添加标签 kubectl label < resourc e> < resourceNam e> < ke y> = < valu e>
# 示例 kubectl label pod rc-demo-c5446 version=v1 kubectl label node node-1 disktype=ssd kubectl label namespace dev environment=development
# 2) 修改标签 kubectl label < resourc e> < resourceNam e> < ke y> = < valu e> --overwrite
# 示例 kubectl label pod rc-demo-c5446 app=yangjun --overwrite
# 3) 删除标签 kubectl label < resourc e> < resourceNam e> < ke y> -
# 示例 kubectl label pod rs-exist-demo-jktxz app-
# 等式匹配 kubectl get pod -l app=nginx # 等于 kubectl get pod -l app!=nginx # 不等于 kubectl get pod -l 'app=nginx,version=v1' # 同时满足多个条件(AND)
# 集合匹配 kubectl get pod -l 'app in (nginx,myapp)' # app 在集合中 kubectl get pod -l 'app notin (nginx)' # app 不在集合中
# 存在性检查 kubectl get pod -l app # 有 app 这个 key kubectl get pod -l '!app' # 没有 app 这个 key
kubectl scale < resourc e> < resourceNam e> --replicas= < number > [-n < namespac e> ]
# 示例 kubectl scale deployment nginx-deployment --replicas=5 kubectl scale rc rc-demo --replicas=10 kubectl scale statefulset mysql --replicas=3
# 查看当前副本数 kubectl get deployment nginx-deployment -o jsonpath='{.spec.replicas}'
kubectl get deploy [-n < namespac e> ] [-o wide] kubectl describe deploy < deploymentNam e> kubectl get deploy -o yaml > deploy-backup.yaml
# 更新容器镜像 kubectl set image deployment/ < deploymentNam e> < containerNam e> = < newImag e>
# 示例 kubectl set image deployment/nginx-deployment nginx=nginx:1.21 kubectl set image deployment/myapp-deployment myapp=myrepo/myapp:v2.0
# 查看更新状态 kubectl rollout status deployment/nginx-deployment
# 部分更新资源(不打乱其他配置) kubectl patch deployment < deploymentNam e> -p '<json-patch>' [-n < namespac e> ]
# 示例:调整滚动更新策略 kubectl patch deployment deployment-demo -p \ '{"spec":{"strategy":{"rollingUpdate":{"maxSurge":1,"maxUnavailable":0}}}}'
# 也可以使用 strategic merge patch kubectl patch deployment nginx-deployment --type= 'strategic' -p ' spec: template: spec: containers: - name: nginx resources: limits: memory: "256Mi" '
# ========== 创建 ========== # 命令行创建 kubectl create deployment mynginx --image=nginx:v1 --port=80
# 导出 YAML 模板 kubectl create deployment mynginx --image=nginx:v1 --dry-run=client -o yaml > deploy.yaml
# ========== 扩缩容 ========== # 手动调整副本数 kubectl scale deployment nginx-deployment --replicas=10
# 自动扩缩容 kubectl autoscale deployment nginx-deployment --min=2 --max=10 --cpu-percent=80
# ========== 更新 ========== # 更新镜像版本 kubectl set image deployment/nginx-deployment nginx=nginx:v2.0
# 编辑在线更改 kubectl edit deployment nginx-deployment
# 使用文件更新 kubectl apply -f deployment.yaml
# 查看更新过程 kubectl rollout status deployment/nginx-deployment
# ========== 回滚 ========== # 查看历史版本 kubectl rollout history deployment/nginx-deployment kubectl rollout history deployment/nginx-deployment --revision=3 # 查看特定版本详情
# 回滚到上一个版本 kubectl rollout undo deployment/nginx-deployment
# 回滚到指定版本 kubectl rollout undo deployment/nginx-deployment --to-revision=2
# ========== 暂停/恢复 ========== # 暂停更新(用于金丝雀发布) kubectl rollout pause deployment/nginx-deployment
# 恢复更新 kubectl rollout resume deployment/nginx-deployment
# ========== 重启 ========== # 滚动重启 Pod kubectl rollout restart deployment/nginx-deployment
# 1. 查看回滚状态(通过返回值判断) kubectl rollout status deployment/nginx-deployment echo $? # 0 表示成功
# 2. 查看回滚历史记录(需要创建时加 --record) kubectl apply -f deployment.yaml --record kubectl rollout history deployment/nginx-deployment
# 3. 查看指定版本详情 kubectl rollout history deployment/nginx-deployment --revision=2
# 4. 回滚到指定版本 kubectl rollout undo deployment/nginx-deployment --to-revision=2
# 5. 资源配置文件备份方式实现回滚 cp deployment.yaml deployment_v1_2025_07_27_08_55.yaml kubectl apply -f deployment.yaml
# 需要回滚时 kubectl apply -f deployment_v1_2025_07_27_08_55.yaml
# 6. 版本清理 # 设置 spec.revisionHistoryLimit 限制保留的旧 ReplicaSet 数量 kubectl patch deployment nginx-deployment -p '{"spec":{"revisionHistoryLimit":5}}'
# 1. create - 命令式创建 kubectl create -f template.yaml # 特点:严格创建,如果资源已存在则报错 # 适用:首次创建资源
# 2. apply - 声明式管理(推荐) kubectl apply -f template.yaml # 特点:创建或更新,基于 last-applied-configuration 注解做三向合并 # 适用:日常管理,文件即真实来源
# 3. replace - 命令式替换 kubectl replace -f template.yaml # 特点:完全替换,如果对象不存在则报错 # 适用:需要完整替换配置时 # 注意:需要先获取当前对象再替换(或加 --force 强制替换)
声明式(Declarative)— 推荐方式: - 描述期望的最终结果,而不是执行步骤 - "应该有一个包含 3 个 Pod 的 ReplicaSet" - 操作:kubectl apply -f deployment.yaml - 好处:幂等、可重复、适合 GitOps
命令式(Imperative): - 直接给出执行指令 - "创建一个包含 3 个 Pod 的 ReplicaSet" - 操作:kubectl create / kubectl run / kubectl scale - 适合:快速调试、临时操作
实用命令: # 显示当前配置与指定文件的差异 kubectl diff -f deployment.yaml
# 查看服务端应用的配置 kubectl get deployment nginx-deployment -o yaml > server.yaml diff deployment.yaml server.yaml
# 在线编辑资源 kubectl edit < resourc e> < resourceNam e> [-n < namespac e> ]
# 示例:编辑 ConfigMap 修改代理模式 kubectl edit configmap kube-proxy -n kube-system # 将 mode: "" 改为 mode: "ipvs"
# 更改后,需要重启 kube-proxy kubectl delete pod -n kube-system -l k8s-app=kube-proxy
# 常用 edit 场景 kubectl edit deployment nginx-deployment # 调整副本数、镜像 kubectl edit service nginx-service # 调整端口 kubectl edit configmap nginx-config # 调整配置
# 查看节点污点 kubectl describe node < nodeNam e> | grep Taints kubectl get node < nodeNam e> -o jsonpath='{.spec.taints}'
# 给节点打污点 kubectl taint node < nodeNam e> < ke y> = < valu e> : < effec t>
# 示例 kubectl taint node master node-role.kubernetes.io/master=:NoSchedule kubectl taint node node-1 gpu= true :NoSchedule kubectl taint node node-2 disk=ssd:PreferNoSchedule
# 删除污点(key 后面加 -) kubectl taint node master node-role.kubernetes.io/master:NoSchedule- kubectl taint node node-1 gpu= true :NoSchedule-
# effect 类型说明: # NoSchedule: 不允许调度新 Pod,但不影响已有 Pod # PreferNoSchedule: 尽量不调度到此节点(软限制) # NoExecute: 不允许调度,并驱逐已有不匹配容忍的 Pod
# 查看节点标签 kubectl get nodes --show-labels
# 添加/修改标签 kubectl label node < nodeNam e> < ke y> = < valu e> kubectl label node < nodeNam e> < ke y> = < valu e> --overwrite
# 删除标签 kubectl label node < nodeNam e> < ke y> -
# 示例 kubectl label node node-1 disktype=ssd kubectl label node node-2 zone=us-east-1a
# 封锁节点(不允许调度新 Pod) kubectl cordon < nodeNam e>
# 解除封锁 kubectl uncordon < nodeNam e>
# 驱逐节点上的 Pod(先封锁,再迁移 Pod) kubectl drain < nodeNam e> --ignore-daemonsets --delete-emptydir-data
# 常用选项 kubectl drain < nodeNam e> \ --ignore-daemonsets \ # 忽略 DaemonSet 管理的 Pod --delete-emptydir-data \ # 删除使用 emptyDir 的 Pod --force \ # 强制驱逐(不受 ReplicationController 等管理的 Pod) --grace-period = 60 # 优雅终止等待时间
Pod 生命周期完整序列:
1. API Server 收到创建请求 → 写入 etcd 2. Scheduler 发现未调度的 Pod → 经过过滤和打分 → 绑定到最优 Node 3. 目标 Node 的 kubelet 收到事件 → 开始创建 Pod
具体创建过程:
(1) Pause 容器启动(Infra Container) ① 初始化网络命名空间(分配 Pod IP) ② 挂载可能有的存储卷 ③ 建立与其他容器共享的 Network、IPC、PID 命名空间 ④ 作为 PID 1 进程,回收孤儿/僵尸进程
(2) Init 容器(Init Containers)按顺序执行 ① 只在 Pod 生命周期的初始化阶段存在 ② 严格按照定义顺序串行执行 ③ 上一个 Init 容器成功退出(exit 0)后,下一个才会启动 ④ 如果上一个 Init 容器返回码不为 0: - Pod 的 restartPolicy 为 Always 时 → 重新创建该 Init 容器,直到成功 - restartPolicy 为 Never 时 → 不会重新启动,Pod 状态 Failed ⑤ 任意一个 Init 容器失败 → 全部从头重新执行 ⑥ Init 容器可以设置重启延迟(利用失败重试的特性做延迟操作) ⑦ 无法定义 readinessProbe(就绪探针只能用于普通容器) ⑧ 支持所有普通容器的字段(资源限制、卷挂载、环境变量、安全上下文等)
(3) Main 容器(普通容器)并发启动 ① 所有主容器并发启动 ② 钩子(Hook):由当前节点的 kubelet 执行 - PostStart:容器启动后立即执行(与 ENTRYPOINT 并发执行,不保证顺序) - PreStop:容器终止前执行(阻塞,在发送 SIGTERM 前完成) ③ 探针(Probe):由当前节点的 kubelet 周期执行 - startupProbe(启动探针):先于其他探针执行,成功后才启动后续探针 - readinessProbe(就绪探针):决定 Pod 是否纳入 Service 端点 - livenessProbe(存活探针):决定容器是否需要重启
注意:如果服务不指定存活探针,kubelet 只根据容器进程是否存活来判断。
(4) Pod 终止流程 ① 用户执行 kubectl delete pod 或 Pod 被驱逐 ② Pod 状态变为 Terminating ③ kubelet 执行 PreStop Hook(如果配置了) ④ kubelet 向容器主进程发送 SIGTERM 信号 ⑤ 等待 terminationGracePeriodSeconds 秒(默认 30 秒) ⑥ 如果超时仍未退出 → 发送 SIGKILL 强制杀死 ⑦ 清理资源(IP、Volume 等)
优雅终止与强制终止:
在 K8s 中,理想状态是 Pod 优雅释放,但并非每个 Pod 都会顺利: - Pod 卡死,无法处理优雅退出命令或操作 - 优雅退出的逻辑有 BUG,陷入死循环 - 代码问题,导致执行的命令没有效果
terminationGracePeriodSeconds 机制: - 默认值 30 秒(在 Pod.spec.terminationGracePeriodSeconds 定义) - kubectl delete pod 时可用 --grace-period=<秒> 显式覆盖 - 超时后 K8s 强制 kill Pod(SIGKILL)
注意事项: - PreStop Hook 和 SIGTERM 信号是并行发生的,K8s 不会等待 PreStop Hook 完成 - 如果应用在 terminationGracePeriod 完成之前自行退出,K8s 立即进入下一步清理 - 建议 PreStop Hook 执行时间 < terminationGracePeriodSeconds
initC、startupProbe、livenessProbe、readinessProbe、hook 都可以选择使用全部、部分或完全不用,它们的存在确保了 Pod 在整个生命周期的高度可控性。
Pod 的 .spec.restartPolicy 定义了容器退出的处理方式:
Always(默认): - 容器退出后总是重启 - 适用于 Deployment、StatefulSet、DaemonSet - kubelet 采用指数退避(10s、20s、40s...最大 5 分钟)
OnFailure: - 只有容器以非零退出码退出才重启 - 适用于 Job(批处理任务)
Never: - 容器退出后永不重启 - 适用于一次性任务
探针是由 kubelet 对容器执行的定期诊断。要执行诊断,kubelet 调用由容器实现的 Handler。
三种类型的处理程序(Handler):
1. ExecAction: 在容器内执行指定命令。如果命令退出时返回码为 0,则诊断成功。
2. TCPSocketAction: 对指定端口上的容器 IP 地址进行 TCP 检测。如果端口打开,则诊断成功。
3. HTTPGetAction: 对指定的端口和路径上的容器 IP 地址执行 HTTP GET 请求。 如果响应状态码 200 ≤ code < 400,则诊断成功。
可选参数: - scheme: HTTP 或 HTTPS(默认 HTTP) - httpHeaders: 自定义请求头 4. GRPCAction(K8s v1.24+ Beta): 使用 gRPC 健康检查协议进行诊断
每次探测将获得以下三种结果之一: - 成功(Success):容器通过了诊断 - 失败(Failure):容器未通过诊断 - 未知(Unknown):诊断本身失败,不会采取任何行动
所有探针共享的配置参数:
initialDelaySeconds: 容器启动后等待多少秒开始探测(默认 0,最小 0)
periodSeconds: 执行探测的时间间隔(默认 10s,最小 1)
timeoutSeconds: 探测超时等待时间(默认 1s,最小 1)
successThreshold: 探测失败后,连续成功多少次才认为成功(默认 1,必须为 1 才能激活)
failureThreshold: 探测成功后,连续失败多少次才认为失败(默认 3,最小 1)
作用: K8s 通过就绪探针,确保只有准备好的 Pod 才能接收流量。 尤其是在扩容、滚动更新时,保证提供给用户的服务都是可用的。
示例——HTTP 就绪探针: readinessProbe: httpGet: path: /healthz port: 8080 scheme: HTTP initialDelaySeconds: 5 periodSeconds: 10 timeoutSeconds: 3 successThreshold: 1 failureThreshold: 3
示例——TCP 就绪探针: readinessProbe: tcpSocket: port: 3306 initialDelaySeconds: 15 periodSeconds: 20
示例——Exec 就绪探针: readinessProbe: exec: command: - cat - /tmp/healthy initialDelaySeconds: 5 periodSeconds: 5
注意事项: 1. 如果 Pod 内部的容器不添加就绪探针,则默认就绪 2. 添加就绪探针后,只有探针通过后,Pod 才被标记为就绪 3. 当前 Pod 中所有容器都就绪,才标记该 Pod 就绪 4. 就绪探针在容器整个生命周期中持续执行 5. Pod 未就绪时,会被从 Service 的 Endpoints 中移除
作用: K8s 通过存活探针,解决"进程还在但已经死锁/卡住"的问题。 如果存活探针失败,容器会被杀死并按照 restartPolicy 重启。
示例——HTTP 存活探针: livenessProbe: httpGet: path: /health port: 8080 httpHeaders: - name: Custom-Header value: Awesome initialDelaySeconds: 30 periodSeconds: 15 timeoutSeconds: 5 failureThreshold: 3
示例——Exec 存活探针: livenessProbe: exec: command: - /bin/sh - -c - "curl -f http://localhost:8080/health || exit 1" initialDelaySeconds: 30 periodSeconds: 10
注意事项: 1. 如果 Pod 内部不指定存活探针,可能会发生"容器运行但无法提供服务"的情况 2. 存活探针不宜过于敏感(频繁误判重启),也不宜过于迟钝(故障发现不及时) 3. failureThreshold * periodSeconds 应合理设置,避免因瞬时波动重启 4. 建议存活探针的 initialDelaySeconds > 启动探针的 failureThreshold * periodSeconds 5. 存活探针应该检查应用核心逻辑而非依赖服务(避免连锁故障)
作用: K8s 在 v1.16 版本后增加 startupProbe 探针。 主要解决:启动缓慢的应用在 readinessProbe / livenessProbe 生效前就被判定为失败而不断重启的问题。
工作原理: - 如果设置了 startupProbe,则禁用其他探针,直到它成功为止 - startupProbe 成功 → 开始执行 livenessProbe 和 readinessProbe - startupProbe 失败 → 容器被杀死并重启(和 livenessProbe 行为一致) - startupProbe 未知 → 静默,不采取行动
示例——启动探针(适合启动需要 2 分钟的应用): startupProbe: httpGet: path: /healthz port: 8080 failureThreshold: 30 # 最多探测 30 次 periodSeconds: 10 # 每 10 秒一次 # 最多等待 30 × 10 = 300 秒 = 5 分钟
配置建议: - failureThreshold * periodSeconds 应大于应用的最长启动时间 - 不给 initialDelaySeconds 设太长的值,而应该增加 failureThreshold - 启动探针成功后,livenessProbe 和 readinessProbe 接管后续检测
Pod Hook 是由 kubelet 管理的生命周期钩子,在容器的特定时刻执行。
Hook 类型: 1. PostStart(启动后钩子): - 容器创建后立即执行 - 与 ENTRYPOINT 并发执行,不能保证先后顺序 - 钩子执行失败 → 容器被杀死 - 适用场景:配置文件初始化、注册服务
2. PreStop(停止前钩子): - 容器终止之前执行 - 阻塞执行,必须完成之后才会发送 SIGTERM 信号 - 钩子执行失败 → 容器仍然被终止 - 适用场景:优雅关闭连接、清理临时文件、通知其他服务
Handler 类型(与探针相同): - exec:在容器内执行命令 - httpGet:发送 HTTP 请求
示例: lifecycle: postStart: exec: command: ["/bin/sh", "-c", "echo 'Hello' > /usr/share/message"] preStop: exec: command: ["/usr/sbin/nginx", "-s", "quit"] # 优雅关闭 Nginx
注意: - PostStart 失败会导致容器终止(restartPolicy 决定是否重启) - PreStop 在 SIGTERM 之前执行,但不能保证一定执行成功 - PreStop 执行时间包含在 terminationGracePeriodSeconds 内
在 Kubernetes 中运行了一系列控制器,确保集群的当前状态与期望状态保持一致。 它们是 Kubernetes 集群内部的控制循环,或者说是"管理中心"。
控制器的工作原理(控制循环): 1. 监视(Watch)资源的当前状态 2. 比较(Diff)当前状态与期望状态 3. 执行(Act)操作,将当前状态调整为期望状态 4. 循环往复
例如: - ReplicaSet 控制器:维护运行中的 Pod 数量与期望副本数一致 - Node 控制器:监控节点状态,节点故障时执行自动化修复流程 - Service 控制器:根据 Service 和 Pod 状态,维护 Endpoints
1. ReplicationController(RC)和 ReplicaSet(RS) 确保 Pod 副本数恒定,RC 已逐步被 RS 取代
2. Deployment 管理 RS 和 Pod,提供声明式更新、滚动发布、回滚能力
3. DaemonSet 确保每个(或指定)Node 运行一个 Pod 副本
4. StatefulSet 管理有状态应用,提供稳定的网络标识和持久存储
5. Job / CronJob Job:一次性任务,确保 Pod 成功完成 CronJob:基于时间的周期性任务
6. Horizontal Pod Autoscaler(HPA) 根据 CPU/内存/自定义指标自动调整 Pod 副本数
ReplicationController(RC): - 确保容器应用的副本数始终保持在用户定义的副本数 - 如果有 Pod 异常退出,自动创建新 Pod 替代 - 如果多出 Pod,自动回收 - 已被 ReplicaSet 取代(新项目建议使用 RS)
ReplicaSet(RS): - 与 RC 功能相同,但支持集合式的 Label Selector - selector 支持 matchLabels 和 matchExpressions 两种方式 - RS 是 Deployment 的底层实现
RC 与 RS 的区别: - RC:selector 只支持等式(key=value) - RS:selector 支持集合操作(matchLabels + matchExpressions)
apiVersion : v1 kind : ReplicationController metadata : name : rc-demo namespace : default spec : replicas : 5 # 期望副本数 selector : app : nginx # 选择器(只支持等式) template : # Pod 模板 metadata : labels : app : nginx spec : containers : - image : nginx:v1 name : mynginx imagePullPolicy : IfNotPresent resources : requests : cpu : 100m memory : 128Mi limits : cpu : 200m memory : 256Mi livenessProbe : httpGet : path : / port : 80 initialDelaySeconds : 30 periodSeconds : 30 timeoutSeconds : 5 readinessProbe : httpGet : path : / port : 80 initialDelaySeconds : 30 periodSeconds : 30 timeoutSeconds : 5 env : - name : GET_HOST_NAME value : dns ports : - containerPort : 80 name : http
apiVersion : apps/v1 kind : ReplicaSet metadata : labels : app : nginx name : nginx-rs-demo namespace : default spec : replicas : 5 # 期望副本数 selector : matchLabels : # 等值匹配 app : nginx # 也可以使用 matchExpressions(集合匹配) # matchExpressions: # - key: app # operator: In # values: # - nginx # - spring-k8s template : # Pod 模板 metadata : labels : app : nginx spec : containers : - name : nginx image : nginx:v1 ports : - name : http containerPort : 80 imagePullPolicy : IfNotPresent
Deployment 为 Pod 和 ReplicaSet 提供了声明式管理方法,取代 ReplicationController 来管理应用。
典型应用场景: 1. 创建 Deployment 来部署 Pod 和 ReplicaSet 2. 滚动升级和回滚应用 3. 扩容和缩容 4. 暂停和继续 Deployment(实现金丝雀发布) 5. 清理旧的 ReplicaSet
Deployment 的优势: - 零停机滚动更新 - 自动版本记录和历史回滚 - 支持暂停/恢复发布流程 - 声明式配置管理
apiVersion : apps/v1 kind : Deployment metadata : name : deployment-demo labels : app : deployment-demo namespace : default spec : replicas : 5 # 副本数 revisionHistoryLimit : 10 # 保留的历史版本数量 strategy : # 更新策略 type : RollingUpdate rollingUpdate : maxSurge : 25% # 滚动更新时最多超出多少个 Pod maxUnavailable : 25% # 滚动更新时最多不可用多少个 Pod selector : matchLabels : app : tomcat template : metadata : labels : app : tomcat spec : containers : - image : tomcat:v1 name : tomcat ports : - containerPort : 8080 name : http resources : requests : cpu : 200m memory : 256Mi limits : cpu : 500m memory : 512Mi
Deployment 的层级关系: Deployment → ReplicaSet → Pod
Deployment 实际通过控制 RS 控制器来控制 Pod 的状态: 1. 创建 Deployment → 自动创建 RS → RS 创建 Pod 2. 更新 Deployment → 创建新 RS → 逐步增加新 RS 副本、减少旧 RS 副本 3. 回滚 → 重新激活旧 RS → 减少新 RS 副本、增加旧 RS 副本
--record 参数: kubectl apply -f deployment-version-demo.yaml --record 记录当前版本的变更原因到注解中(kubernetes.io/change-cause)
版本号继承规则: 如果上一次记录了当前版本,而下一次没有使用 --record 则下一次的版本信息会默认采用该版本上一次记录的版本信息
旧 RS (3 Pods) 新 RS (0 Pods) [P1] [P2] [P3]
→ 扩容新 RS:新 RS 增加 1 个 Pod 旧 RS (3 Pods) 新 RS (1 Pod) [P1] [P2] [P3] [P4]
→ 缩容旧 RS:旧 RS 减少 1 个 Pod 旧 RS (2 Pods) 新 RS (1 Pod) [P2] [P3] [P4]
→ 重复上述过程... 旧 RS (0 Pods) 新 RS (3 Pods) [P4] [P5] [P6]
# 控制保留的历史 RS 数量 spec : revisionHistoryLimit : 10 # 默认保留所有,建议设一个合理值
# 设为 0 时 Deployment 不允许回退 # 建议:生产环境保留 5-10 个版本
# 策略类型 spec : strategy : type : RollingUpdate # 滚动更新(默认) # type: Recreate # 重建更新(先全删再全建,有停机时间)
# RollingUpdate 参数 rollingUpdate : maxSurge : 1 # 可以超出期望副本数的最大数量(支持数字或百分比) maxUnavailable : 0 # 更新过程中最多不可用的 Pod 数量(支持数字或百分比)
# 说明: # maxSurge: 1 → 保证副本数最多不超过 replicas + 1 # maxUnavailable: 1 → 保证至少 replicas - 1 个 Pod 始终可用 # # Kubernetes 早期版本默认值:maxSurge=1, maxUnavailable=1 # 新版 Kubernetes 默认值改为:maxSurge=25%, maxUnavailable=25% # # Recreate 策略: # 先删除所有旧 Pod,再创建新 Pod → 会有短暂的完全不可用时间
4. 清理旧版本
实现步骤:
# 步骤 1:打补丁设置滚动更新策略(只增加新 Pod,不减少旧 Pod) kubectl patch deployment nginx-deployment -p \ '{"spec":{"strategy":{"rollingUpdate":{"maxSurge":1,"maxUnavailable":0}}}}'
# 步骤 2:更新镜像并立即暂停 kubectl set image deployment/nginx-deployment nginx=nginx:v2.0 kubectl rollout pause deployment/nginx-deployment
# 或一步完成: kubectl patch deployment nginx-deployment --patch ' { "spec": { "template": { "spec": { "containers": [{ "name": "nginx", "image": "nginx:v2.0" }] } } } }' kubectl rollout pause deployment/nginx-deployment
# 步骤 3:验证新 Pod 运行正常 kubectl get pods -l app=nginx # 此时新旧版本共存,新版本 Pod 开始接收部分流量
# 步骤 4:验证通过后恢复滚动更新 kubectl rollout resume deployment/nginx-deployment
# 步骤 5:如果验证失败,回滚 kubectl rollout undo deployment/nginx-deployment
DaemonSet 确保全部(或指定)Node 上运行一个 Pod 副本: - Node 加入集群 → 自动创建对应的 Pod - Node 移除集群 → Pod 被回收 - 删除 DaemonSet → 删除它创建的所有 Pod
典型用法: 1. 集群存储守护进程:glusterd、ceph(在每个节点运行存储客户端) 2. 日志收集守护进程:fluentd、logstash、Filebeat 3. 监控守护进程:Prometheus Node Exporter、Datadog Agent、collectd 4. 网络插件:Calico node、Flannel、Cilium
apiVersion : apps/v1 kind : DaemonSet metadata : name : fluentd-elasticsearch namespace : kube-system labels : k8s-app : fluentd-logging spec : selector : matchLabels : name : fluentd-elasticsearch template : metadata : labels : name : fluentd-elasticsearch spec : tolerations : - key : node-role.kubernetes.io/master effect : NoSchedule # 容忍 master 节点的污点 containers : - name : fluentd-elasticsearch image : fluent/fluentd:v1.12 resources : limits : memory : 200Mi requests : cpu : 100m memory : 200Mi volumeMounts : - name : varlog mountPath : /var/log - name : varlibdockercontainers mountPath : /var/lib/docker/containers readOnly : true terminationGracePeriodSeconds : 30 volumes : - name : varlog hostPath : path : /var/log - name : varlibdockercontainers hostPath : path : /var/lib/docker/containers
spec : updateStrategy : type : RollingUpdate # 默认 rollingUpdate : maxUnavailable : 1 # 同时最多几个节点更新 # type: OnDelete # 只在 Pod 被删除时才创建新 Pod
Job 负责批处理任务,确保指定数量的 Pod 成功完成。
关键字段: spec.template:格式同 Pod 模板 spec.completions:需要成功完成的 Pod 个数(默认 1) spec.parallelism:并行运行的 Pod 个数(默认 1) spec.backoffLimit:失败重试次数(默认 6) spec.activeDeadlineSeconds:Job 运行的最长时间(超时终止) spec.ttlSecondsAfterFinished:完成后自动清理的时间(k8s v1.12+)
RestartPolicy 限制: Job 的 RestartPolicy 仅支持 Never 或 OnFailure(不支持 Always)
apiVersion : batch/v1 kind : Job metadata : name : pi spec : completions : 1 # 需要成功完成的 Pod 数 parallelism : 1 # 并行 Pod 数 backoffLimit : 4 # 失败重试次数 activeDeadlineSeconds : 100 # 超时时间 template : spec : containers : - name : pi image : perl command : [ "perl" , "-Mbignum=bpi" , "-wle" , "print bpi(2000)" ] restartPolicy : Never
1. 单个 Job 运行一个 Pod(默认) completions=1, parallelism=1 适用于单次任务
2. 固定完成次数的并行 Job completions=N, parallelism=M 同时运行 M 个 Pod,直到累计成功完成 N 次 适用于:需要处理多个独立工作项
3. 工作队列的并行 Job 不设置 completions(或设为 1),parallelism=M 每个 Pod 从队列中取任务处理 适用于:消息队列消费者模式
CronJob 管理基于时间的 Job:
关键字段: .spec.schedule:Cron 表达式,必需字段 .spec.jobTemplate:Job 模板,必需字段 .spec.startingDeadlineSeconds:启动截止时间(秒),可选 .spec.concurrencyPolicy:并发策略,可选 .spec.successfulJobsHistoryLimit:成功 Job 保留数量(默认 3) .spec.failedJobsHistoryLimit:失败 Job 保留数量(默认 1) .spec.suspend:是否暂停(挂起 CronJob)
Cron 表达式格式(5位):
| 位置 | 含义 | 取值范围 | |------|------|----------| | 第1位 | 分钟 | 0 - 59 | | 第2位 | 小时 | 0 - 23 | | 第3位 | 日 | 1 - 31 | | 第4位 | 月 | 1 - 12 | | 第5位 | 星期 | 0 - 6(0=周日) |
格式:`* * * * *`(对应 分钟 小时 日 月 星期)
示例: "*/5 * * * *" → 每 5 分钟 "0 2 * * *" → 每天凌晨 2 点 "0 9 * * 1-5" → 工作日早上 9 点 "0 0 1 * *" → 每月 1 号午夜
.spec.concurrencyPolicy:
Allow(默认): 允许并发运行 Job。上一次没完成,这次也可以启动。
Forbid: 禁止并发运行。如果上一个还没完成,跳过本次执行。
Replace: 取消当前正在运行的 Job,用新的 Job 替换。
注意: 并发策略只应用于同一个 CronJob 创建的 Job。 不同 CronJob 之间的 Job 总是允许并发运行。
apiVersion : batch/v1 kind : CronJob metadata : name : mysql-backup namespace : default spec : schedule : "0 2 * * *" # 每天凌晨 2 点执行 startingDeadlineSeconds : 300 # 错过时间后 5 分钟内仍然可以启动 concurrencyPolicy : Forbid # 不允许并发 successfulJobsHistoryLimit : 3 # 保留 3 个成功的 Job failedJobsHistoryLimit : 2 # 保留 2 个失败的 Job suspend : false # 不禁用 jobTemplate : spec : template : spec : containers : - name : backup image : mysql:8.0 command : - /bin/sh - -c - | mysqldump -h mysql-service -u root -p${MYSQL_PASSWORD} \ --all-databases > /backup/dump.sql env : - name : MYSQL_PASSWORD valueFrom : secretKeyRef : name : mysql-secret key : password volumeMounts : - name : backup-volume mountPath : /backup restartPolicy : OnFailure volumes : - name : backup-volume persistentVolumeClaim : claimName : backup-pvc
Kubernetes Service 定义了一个 Pod 逻辑分组和访问策略,通常称为"微服务"。
为什么需要 Service: - Pod 的 IP 是动态分配的(重启后 IP 会变) - Deployment 会自动拉起/替换 Pod,新的 Pod IP 会变化 - 如果没有 Service,集群内部的寻址和服务发现会非常困难
Service 的核心能力: - 为一组 Pod 提供稳定的虚拟 IP(ClusterIP) - 通过 Label Selector 动态发现后端 Pod - 提供负载均衡(默认轮询) - 提供 DNS 名称(Service 名.Namespace.svc.cluster.local)
Service 的工作方式: 1. 用户/客户端访问 Service 的 ClusterIP:Port 2. kube-proxy 根据 iptables/IPVS 规则将流量转发到后端 Pod 3. Service 根据 Label Selector 选择匹配的 Pod 作为后端 4. 当后端 Pod 变化时,kube-proxy 自动更新转发规则
Kubernetes v1.0:userspace 模式(唯一支持) Kubernetes v1.1:新增 iptables 模式(非默认) Kubernetes v1.2:iptables 成为默认模式 Kubernetes v1.8:新增 IPVS 模式(Beta) Kubernetes v1.11:IPVS 模式 GA
各模式特点:
userspace(已弃用): - kube-proxy 在用户空间监听端口 - 请求:客户端 → Service IP → kube-proxy(用户空间)→ Pod IP - 需要在内核空间和用户空间之间切换,性能最差 - 延迟高,吞吐量低
iptables(当前默认): - kube-proxy 在 iptables 中写 NAT 规则 - 请求:客户端 → Service IP → iptables 规则 → 随机 DNAT 到 Pod IP - 纯内核态执行,性能好 - 缺点:规则量大时(数千 Service)性能下降严重;负载均衡是随机选择
IPVS(推荐): - 基于 Linux 内核 IPVS 模块 - 支持多种负载均衡算法:rr、lc、dh、sh、sed、nq - 大规模集群(1000+ Service)性能远超 iptables - 要求:内核加载 ip_vs 模块
配置 kube-proxy 为 IPVS 模式: 编辑 kube-proxy ConfigMap: kubectl edit configmap kube-proxy -n kube-system 修改 mode: "" → mode: "ipvs" 重启 kube-proxy Pod: kubectl delete pod -n kube-system -l k8s-app=kube-proxy
end
subgraph "IPVS 负载均衡器(内核态)" SVC --> IPVS["IPVS Kernel Module<br>哈希表: Service 到 Endpoints"] IPVS -- "负载均衡算法<br>(rr, lc, dh, sh...)" --> LB{ } end
subgraph "后端 Pod 实例" LB -->|"DNAT 到 Pod IP"| P1["Pod A<br>IP: 172.16.1.2"] LB -->|"DNAT 到 Pod IP"| P2["Pod B<br>IP: 172.16.2.3"] LB -->|"DNAT 到 Pod IP"| P3["Pod C<br>IP: 172.16.3.4"] end
style SVC fill:#e1f5fe style IPVS fill:#f1f8e9 -->
end
subgraph "iptables 规则链" SVC2 --> KUBE_SVC["KUBE-SERVICES 链"] KUBE_SVC -->|"匹配 Service 规则"| KUBE_SVC_XXX["KUBE-SVC-XXX 链"] KUBE_SVC_XXX -->|"随机概率选择"| KUBE_SEP_YYY1["KUBE-SEP-YYY1 (Pod A)"] KUBE_SVC_XXX -->|"随机概率选择"| KUBE_SEP_YYY2["KUBE-SEP-YYY2 (Pod B)"] KUBE_SVC_XXX -->|"随机概率选择"| KUBE_SEP_YYY3["KUBE-SEP-YYY3 (Pod C)"] end
subgraph "后端 Pod 实例" KUBE_SEP_YYY1 -->|"DNAT 到 Pod A"| P4["Pod A<br>IP: 172.16.1.2"] KUBE_SEP_YYY2 -->|"DNAT 到 Pod B"| P5["Pod B<br>IP: 172.16.2.3"] KUBE_SEP_YYY3 -->|"DNAT 到 Pod C"| P6["Pod C<br>IP: 172.16.3.4"] end
style KUBE_SVC fill:#ffecb3 style KUBE_SVC_XXX fill:#ffcdd2 style KUBE_SEP_YYY1 fill:#dcedc8 -->
ClusterIP 是默认的 Service 类型: - 分配一个集群内部的虚拟 IP - 只能被集群内的 Pod 或节点访问 - 可以通过 DNS 名称访问:<service-name>.<namespace>.svc.cluster.local
适用场景: - 微服务之间的内部通信 - 前端 Pod 访问后端 Pod - 应用访问数据库(通过 Service 而不是 Pod IP)
特殊用法: ClusterIP: None → Headless Service - 不分配 ClusterIP - DNS 直接返回 Pod IP 列表(而非 Service IP) - 适用于 StatefulSet、自定义负载均衡等场景
NodePort 在 ClusterIP 基础上,在每个节点上绑定一个端口: - 端口范围:30000-32767(可配置 --service-node-port-range) - 可以通过 <任意NodeIP>:<NodePort> 访问服务 - kube-proxy 自动在节点上创建 iptables 规则转发流量
访问方式: http://<NodeIP>:30001 → Service → Pod
适用场景: - 开发测试环境(快速暴露服务) - 没有负载均衡器的环境 - 简单的外部访问需求
注意事项: - 每个 Service 在每个节点上绑定端口(端口占用) - 不建议在生产环境大规模使用(端口管理复杂)
LoadBalancer 在 NodePort 基础上,借助云厂商创建一个外部负载均衡器: - 自动创建一个外部 IP(由云厂商分配) - 外部请求 → 负载均衡器 → 节点 NodePort → Pod - 需要云厂商支持(AWS ELB、GCP LB、阿里云 SLB 等)
适用场景: - 生产环境的外部访问 - 需要固定的外部 IP 或域名
裸机集群的替代方案: - MetalLB:为裸机集群提供 LoadBalancer 实现 - 使用 Ingress + Ingress Controller 代替
ExternalName 将集群外部的服务引入到集群内部: - 不创建任何代理或转发规则 - 只在 DNS 层面做 CNAME 映射 - 集群内通过 Service 名称访问 → 实际指向外部服务
适用场景: - 访问托管的外部数据库(如 RDS) - 访问 SaaS 服务 - 逐步迁移(先从外部服务过渡到内部部署)
示例: apiVersion: v1 kind: Service metadata: name: external-db spec: type: ExternalName externalName: mydb.rds.amazonaws.com
apiVersion : v1 kind : Service metadata : name : service-demo namespace : default labels : app : tomcat spec : type : ClusterIP # Service 类型 # clusterIP: 10.96.0.1 # 可选,手动指定 ClusterIP selector : # 选择后端 Pod app : tomcat ports : - name : http port : 8080 # Service 对外暴露的端口 targetPort : 8080 # 后端 Pod 的端口 protocol : TCP # 多端口 Service 示例 # - name: https # port: 443 # targetPort: 8443 # protocol: TCP sessionAffinity : None # 会话亲和性(None/ClientIP) # sessionAffinity: ClientIP # sessionAffinityConfig: # clientIP: # timeoutSeconds: 10800
apiVersion : v1 kind : Service metadata : name : service-nodeport-demo namespace : default spec : type : NodePort selector : app : myapp release : stable ports : - name : http port : 8080 # Service 端口 targetPort : 8080 # Pod 端口 nodePort : 30001 # 节点端口(不指定则自动分配) protocol : TCP
Headless Service (clusterIP: None):
DNS 查询 → 直接返回所有就绪 Pod 的 IP 列表(如 172.16.1.2, 172.16.2.3)
→ 客户端直接连接 Pod,绕过 kube-proxy
--- # ========== 1. Headless Service ========== apiVersion : v1 kind : Service metadata : name : mysql-headless # 无头服务名称 namespace : default spec : clusterIP : None # 关键:ClusterIP 设为 None selector : app : mysql # 选择标签为 app=mysql 的 Pod ports : - port : 3306 targetPort : 3306 name : mysql --- # ========== 2. StatefulSet ========== apiVersion : apps/v1 kind : StatefulSet metadata : name : mysql namespace : default spec : serviceName : mysql-headless # 必须指定 Headless Service 名称 replicas : 3 selector : matchLabels : app : mysql template : metadata : labels : app : mysql spec : containers : - name : mysql image : mysql:8.0 ports : - containerPort : 3306 volumeMounts : - name : data mountPath : /var/lib/mysql volumeClaimTemplates : # 每个 Pod 自动创建独立 PVC - metadata : name : data spec : accessModes : [ "ReadWriteOnce" ] resources : requests : storage : 10Gi
# StatefulSet 创建 3 个 Pod 后,DTOP/IP 映射如下: mysql-0.mysql-headless.default.svc.cluster.local → 172.16.1.10 (Pod 0) mysql-1.mysql-headless.default.svc.cluster.local → 172.16.2.20 (Pod 1) mysql-2.mysql-headless.default.svc.cluster.local → 172.16.3.30 (Pod 2)
# StatefulSet 保证: # - Pod 名称固定:mysql-0, mysql-1, mysql-2(永远不变) # - 启动顺序:0 → 1 → 2(顺序启动) # - 删除顺序:2 → 1 → 0(逆序删除) # - PVC 绑定到 Pod:mysql-0 始终绑定 data-mysql-0 PVC
# 同时还存在一条 SRV 记录,返回 (hostname, port, priority, weight): mysql-headless.default.svc.cluster.local (SRV 记录) → 0 50 3306 mysql-0.mysql-headless.default.svc.cluster.local. → 0 50 3306 mysql-1.mysql-headless.default.svc.cluster.local. → 0 50 3306 mysql-2.mysql-headless.default.svc.cluster.local.
--- # ========== 1. Headless Service(无 selector)========== apiVersion : v1 kind : Service metadata : name : external-db namespace : default spec : clusterIP : None # Headless # 注意:没有 selector 字段 ports : - port : 3306 targetPort : 3306 name : mysql --- # ========== 2. 手动创建 Endpoints ========== # Endpoints 名称必须与 Service 名称完全一致 apiVersion : v1 kind : Endpoints metadata : name : external-db # 与 Service 同名 namespace : default subsets : - addresses : - ip : 192.168.1.100 # 集群外部的数据库服务器 IP - ip : 192.168.1.101 ports : - port : 3306 name : mysql
# 应用配置 kubectl apply -f external-db-headless.yaml
# 验证 DNS 解析——直接返回 addresses 中的 IP # 在任意 Pod 中运行 nslookup: nslookup external-db.default.svc.cluster.local # 返回: # Name: external-db.default.svc.cluster.local # Address: 192.168.1.100 # Address: 192.168.1.101
# 1. 验证 Service 是 Headless kubectl get svc mysql-headless # ClusterIP 列显示 None
# 2. 查看 Endpoints(有 selector 时自动生成) kubectl get endpoints mysql-headless # NAME ENDPOINTS AGE # mysql-headless 172.16.1.10:3306,172.16.2.20:3306,172.16.3.30:3306 5m
# 3. 在 Pod 中测试 DNS 解析(需要 Pod 中有 dnsutils 或 nslookup) kubectl run -it --rm dns-test --image=busybox:1.28 --restart=Never -- nslookup mysql-headless
# 4. 查看每个 Pod 的 DNS 配置 kubectl exec mysql-0 -- cat /etc/resolv.conf # 查看 CoreDNS 地址和 search 域
# 5. 测试 SRV 记录 kubectl run -it --rm dns-test --image=busybox:1.28 --restart=Never -- \ nslookup -type=SRV _mysql._tcp.mysql-headless.default.svc.cluster.local
Endpoint 是 Service 的底层实现模型:
Kubernetes 中的 Service 定义了一组 Pod 的逻辑集合和访问策略。 Service 的目标 Pod 集合通常由 Label Selector 决定。 Endpoint 则是一组实际可访问的服务端点集合。
一个 Endpoint 是一个可被访问的服务端点,即状态为 Running 且就绪的 Pod 的网络端点。 一组 Pod 的端点合在一起称为 Endpoints。
只有被 Service Selector 匹配选中且状态为 Running 的 Pod,才会被加入到与 Service 同名的 Endpoints 中。
查看 Endpoint: kubectl get endpoints kubectl describe endpoints <service-name>
apiVersion : v1 kind : Endpoints metadata : name : service-not-selector # 必须与对应的 Service 同名 namespace : default subsets : - addresses : - ip : 192.168.91.200 # 外部服务 IP - ip : 192.168.91.199 ports : - name : http # 必须与 Service 中 port 的 name 匹配 port : 80 protocol : TCP
# 使未就绪的 Pod 也被添加到 Service 的访问规则中 kubectl patch service < serviceNam e> -p '{"spec":{"publishNotReadyAddresses":true}}'
# 用途: # - DNS 轮询时不等待 Pod 就绪即加入解析列表 # - 应用自定义的健康检查逻辑 # - 调试和测试场景
K8s 存储分为两大类:
一、配置与元数据存储: 1. ConfigMap:保存非敏感配置数据(明文) 2. Secret:保存敏感数据(Base64 编码) 3. Downward API:将 Pod 和容器元信息暴露给容器(如 Pod 名、命名空间、标签等)
二、真实数据存储: 1. Volume(普通卷):临时或持久性数据存储,生命周期与 Pod 绑定 2. PersistentVolume(持久卷):独立于 Pod 生命周期的持久化存储 3. StorageClass(存储类):动态创建 PV 的模板
ConfigMap 是一个 API 对象,用于存储非机密数据,以键值对形式保存。
主要用途: - 设置环境变量的值 - 在容器中设置命令行参数 - 在卷中创建配置文件(挂载为文件)
重要特性: - 使用 data 字段存储 UTF-8 字符串 - 使用 binaryData 字段存储 Base64 编码的二进制数据 - data 和 binaryData 的键名不能重叠 - 键名只能由字母数字字符或 -、_、. 组成 - 从 v1.19 开始,支持设置 immutable 字段创建不可变更的 ConfigMap
ConfigMap vs Secret: - ConfigMap:明文存储,适合配置文件、环境变量 - Secret:Base64 编码存储(非加密!),适合密码、令牌、密钥 - 两者使用方式几乎相同
# 方式一:从文件读取键值对(文件名=key,文件内容=value) kubectl create configmap < configMapNam e> --from-file= < filename > kubectl create configmap < configMapNam e> --from-file= < key > = < filename >
# 示例 kubectl create configmap game-config --from-file=game.properties kubectl create configmap game-config --from-file=config=game.properties
# 从目录读取(目录中所有文件作为键值对) kubectl create configmap app-config --from-file=configs/
# 方式二:从命令行参数读取 kubectl create configmap < configMapNam e> --from-literal= < key > = < value >
# 示例 kubectl create configmap game-config \ --from-literal=name=zhangsan \ --from-literal=level=hard \ --from-literal=player.count=2
# 混合使用 kubectl create configmap app-config \ --from-file=app.properties \ --from-literal=LOG_LEVEL=INFO \ --from-literal=DB_HOST=mysql-service
# ============ ConfigMap 1:键值对形式 ============ apiVersion : v1 kind : ConfigMap metadata : name : literal-config namespace : default data : name : yangjun password : test --- # ============ ConfigMap 2:环境变量配置 ============ apiVersion : v1 kind : ConfigMap metadata : name : env-config namespace : default data : LOG_LEVEL : INFO DB_HOST : "mysql.default.svc.cluster.local" DB_PORT : "3306" --- # ============ ConfigMap 3:配置文件形式 ============ apiVersion : v1 kind : ConfigMap metadata : name : nginx-config namespace : default data : nginx.conf : | server { listen 80; server_name localhost; location / { root /usr/share/nginx/html; index index.html; } } --- # ============ Pod 使用 ConfigMap ============ apiVersion : v1 kind : Pod metadata : name : configmap-env-test namespace : default spec : containers : - name : myapp-container image : nginx:v1 command : [ "/bin/sh" , "-c" ] args : - | echo "$USERNAME $PASSWORD $LOG_LEVEL" > /tmp/configMap.txt tail -f /dev/null env : - name : USERNAME # 引用单个 key valueFrom : configMapKeyRef : name : literal-config key : name - name : PASSWORD # 引用单个 key valueFrom : configMapKeyRef : name : literal-config key : password envFrom : # 引用整个 ConfigMap 的所有 key - configMapRef : name : env-config
--- # ========== ConfigMap 定义 ========== apiVersion : v1 kind : ConfigMap metadata : name : nginx-config data : nginx.conf : | server { listen 80; server_name localhost; location / { root /usr/share/nginx/html; index index.html; } } vhost.conf : | server { listen 8080; server_name admin.localhost; location / { root /usr/share/nginx/admin; } } --- # ========== Pod 挂载 ConfigMap ========== apiVersion : v1 kind : Pod metadata : name : nginx-configmap-volume spec : containers : - name : nginx image : nginx:latest volumeMounts : - name : config-volume mountPath : /etc/nginx/conf.d # 挂载后此目录包含文件:nginx.conf, vhost.conf readOnly : true volumes : - name : config-volume configMap : name : nginx-config
sites/default.conf
items[].mode 文件权限(八进制) 0644 0600
--- # ========== 示例 1:items 选择指定 key 并重命名 ========== apiVersion : v1 kind : Pod metadata : name : nginx-items spec : containers : - name : nginx image : nginx:latest volumeMounts : - name : config-volume mountPath : /etc/nginx/conf.d readOnly : true volumes : - name : config-volume configMap : name : nginx-config items : - key : nginx.conf # ConfigMap 中的 key path : default.conf # 挂载后的文件名 - key : vhost.conf path : vhost.conf
--- # ========== 示例 2:keyToPath 映射到子目录 ========== apiVersion : v1 kind : Pod metadata : name : app-subpath spec : containers : - name : app image : myapp:latest volumeMounts : - name : config-volume mountPath : /app/configs readOnly : true volumes : - name : config-volume configMap : name : app-config items : - key : db.yaml path : database/db.yaml # 创建子目录 database/,文件放在其下 mode : 0644 # 指定文件权限 - key : cache.yaml path : cache/redis.yaml # 创建另一个子目录 cache/ mode : 0600 # 更严格的权限
--- # ========== 示例 3:subPath 挂载单个文件 ========== apiVersion : v1 kind : Pod metadata : name : nginx-subpath spec : containers : - name : nginx image : nginx:latest volumeMounts : # ===== 普通方式:整个目录挂载 ===== - name : config-volume mountPath : /etc/nginx/conf.d # 整个 conf.d 目录被 ConfigMap 覆盖
# ===== subPath 方式:只替换单个文件 ===== - name : config-volume mountPath : /etc/nginx/nginx.conf # 要替换的目标文件路径 subPath : nginx.conf # ConfigMap 中的 key 名 readOnly : true volumes : - name : config-volume configMap : name : nginx-config
--- # ========== 示例 4:subPathExpr 动态路径 ========== apiVersion : v1 kind : Pod metadata : name : app-subpathexpr spec : containers : - name : app image : nginx:latest env : - name : APP_ENV value : production - name : POD_NAME valueFrom : fieldRef : fieldPath : metadata.name # 注入 Pod 名称 volumeMounts : - name : config-volume mountPath : /etc/nginx/nginx.conf subPathExpr : $(APP_ENV)/nginx.conf # 根据环境变量拼接路径 readOnly : true volumes : - name : config-volume configMap : name : nginx-config items : - key : nginx.conf path : production/nginx.conf # 对应 production/nginx.conf - key : staging.conf path : staging/nginx.conf # 对应 staging/nginx.conf
--- # ========== 示例 5:设置默认权限 ========== apiVersion : v1 kind : Pod metadata : name : app-mode spec : containers : - name : app image : myapp:latest volumeMounts : - name : config-volume mountPath : /etc/config readOnly : true volumes : - name : config-volume configMap : name : app-config defaultMode : 0400 # 所有文件默认权限 0400(只读,仅 owner) items : - key : secret.yaml path : secret.yaml mode : 0600 # secret.yaml 单独指定权限 0600,覆盖 defaultMode
400
apiVersion : v1 kind : ConfigMap metadata : name : immutable-config data : app.version : "1.0.0" immutable : true # K8s v1.19+,防止意外修改,提升性能
Secret 用于存储和管理敏感信息,如密码、OAuth 令牌、SSH 密钥等。 与 ConfigMap 类似,但数据以 Base64 编码存储。
Secret 类型: - Opaque(默认):用户自定义的任意数据 - kubernetes.io/service-account-token:ServiceAccount 令牌 - kubernetes.io/dockercfg / kubernetes.io/dockerconfigjson:Docker 仓库认证 - kubernetes.io/tls:TLS 证书 - kubernetes.io/basic-auth:基础认证凭据 - bootstrap.kubernetes.io/token:启动引导令牌
重要安全提示: - Secret 默认以 Base64 编码存储(不是加密!) - etcd 中建议启用静态加密(Encryption at Rest) - 通过 RBAC 限制对 Secret 的访问 - Secret 大小限制 1MB
# 从文件创建 kubectl create secret generic db-secret \ --from-file=username=./username.txt \ --from-file=password=./password.txt
# 从命令行创建 kubectl create secret generic db-secret \ --from-literal=username=admin \ --from-literal=password=MyP@ssw0rd
# 创建 TLS Secret kubectl create secret tls tls-secret \ --cert=path/to/cert.pem \ --key=path/to/key.pem
# 创建 Docker Registry Secret kubectl create secret docker-registry regcred \ --docker-server=myregistry.com \ --docker-username=admin \ --docker-password=MyP@ssw0rd
apiVersion : v1 kind : Secret metadata : name : db-secret namespace : default type : Opaque data : username : YWRtaW4= # echo -n 'admin' | base64 → YWRtaW4= password : TXlQQHNzdzByZA== # echo -n 'MyP@ssw0rd' | base64
# 也可以使用 stringData(写入时明文,存储时自动编码) # stringData: # username: admin # password: MyP@ssw0rd
apiVersion : v1 kind : Pod metadata : name : secret-pod spec : containers : - name : app image : myapp:v1 # 方式一:作为环境变量 env : - name : DB_USERNAME valueFrom : secretKeyRef : name : db-secret key : username - name : DB_PASSWORD valueFrom : secretKeyRef : name : db-secret key : password envFrom : # 方式二:注入所有 key - secretRef : name : db-secret # 方式三:挂载为文件 volumeMounts : - name : secret-volume mountPath : /etc/secrets readOnly : true volumes : - name : secret-volume secret : secretName : db-secret
Volume 解决容器重启后数据丢失和 Pod 内容器间数据共享问题。
K8s 支持的卷类型(部分): - emptyDir:Pod 生命周期内的临时目录 - hostPath:挂载节点上的文件或目录 - nfs:NFS 网络存储 - configMap / secret:配置/密钥卷 - persistentVolumeClaim:PVC 持久卷 - cephfs / glusterfs:分布式文件系统 - awsElasticBlockStore / gcePersistentDisk / azureDisk:云存储
emptyDir: - Pod 被分配到节点时创建,初始为空 - Pod 中所有容器都可以读写 emptyDir 中的文件 - 每个容器可以挂载到相同或不同路径 - Pod 从节点移除时,emptyDir 数据被永久删除 - 容器崩溃不会导致 Pod 从节点移除,所以数据在容器崩溃时是安全的
典型用途: - 暂存空间(排序、计算检查点) - 内容管理器提取文件供 Web 服务器使用 - 多容器共享数据(如 Sidecar 日志收集)
存储位置: kubelet --root-dir 参数控制(默认 /var/lib/kubelet) /var/lib/kubelet/pods/<pod-uid>/volumes/kubernetes.io~empty-dir/<volume-name>/
apiVersion : v1 kind : Pod metadata : name : volume-emptydir-pod namespace : default spec : containers : - name : myapp image : wangyanglinux/myapp:v1.0 ports : - containerPort : 80 volumeMounts : - name : logs-volume mountPath : /usr/local/nginx/logs # 容器内挂载路径 - name : busybox image : wangyanglinux/tools:busybox command : [ "/bin/sh" , "-c" , "touch /logs/access.log && tail -f /logs/access.log" ] volumeMounts : - name : logs-volume mountPath : /logs # 两个容器共享同一卷 volumes : - name : logs-volume emptyDir : medium : "" # 默认使用节点磁盘 # medium: Memory # 使用 tmpfs(内存),速度更快但重启丢失 sizeLimit : 256Mi # 大小限制
hostPath: - 将节点上的文件或目录挂载到 Pod 中 - 同一节点上的 Pod 可以共享数据 - Pod 重启、删除后数据仍然存在(数据在节点上) - 节点故障时数据丢失
注意事项: - hostPath 可能导致 Pod 与特定节点耦合 - 多副本部署时,每个副本可能在不同节点,数据可能不一致 - 建议用于 DaemonSet(如日志收集、监控 Agent) - 安全性:避免挂载敏感目录(如 /etc/kubernetes)
示例: volumes: - name: host-volume hostPath: path: /data type: DirectoryOrCreate # 目录不存在则创建
K8s 持久化存储体系:
PV(PersistentVolume):持久卷 - 集群级别的存储资源(由管理员创建或通过 StorageClass 动态创建) - 独立于 Pod 的生命周期 - 是一块实际的存储(NFS、iSCSI、云存储等)
PVC(PersistentVolumeClaim):持久卷声明 - 用户的存储请求(开发者创建) - 类似于 Pod 请求 CPU/内存,PVC 请求存储 - 指定大小、访问模式等需求
StorageClass:存储类 - 动态创建 PV 的模板 - 定义存储类型和参数(如 SSD/HDD、IOPS、备份策略) - 按需动态创建 PV(Dynamic Provisioning)
使用流程: 静态供应:管理员创建 PV → 用户创建 PVC → K8s 绑定 PV 到 PVC → Pod 使用 PVC 动态供应:用户创建 PVC → StorageClass 自动创建 PV → 绑定 → Pod 使用 PVC
PVC 要绑定到 PV 必须满足以下条件:
1. 容量:PV 的容量 ≥ PVC 要求的容量(不能小于,最好一致)
2. 访问模式(AccessModes):必须完全匹配 - ReadWriteOnce(RWO):单节点读写挂载 - ReadOnlyMany(ROX):多节点只读挂载 - ReadWriteMany(RWX):多节点读写挂载 - ReadWriteOncePod(RWOP):单 Pod 读写挂载(K8s v1.22+)
3. 存储类(StorageClass): - PVC 指定 storageClassName 为空字符串 "" → 只能绑定无 StorageClass 的 PV - PVC 指定 storageClassName 为具体值 → 只能绑定相同 StorageClass 的 PV - PVC 不指定 storageClassName → 绑定默认 StorageClass(如果有的话)
4. 其他匹配条件: - PV 的 Selector 标签匹配 - PV 状态为 Available
Available(可用): 空闲资源,还没有被任何 PVC 绑定
Bound(已绑定): 卷已经被 PVC 绑定
Released(已释放): PVC 被删除,但是资源还未被集群回收
Failed(失败): 该卷的自动回收失败
# ============ PV(NFS 示例)============ apiVersion : v1 kind : PersistentVolume metadata : name : nfs-pv labels : storage : nfs spec : capacity : storage : 10Gi # 容量 volumeMode : Filesystem # 卷模式:Filesystem / Block accessModes : - ReadWriteMany # 访问模式 persistentVolumeReclaimPolicy : Retain storageClassName : nfs # 存储类名称 mountOptions : # 挂载选项 - hard - nfsvers=4.1 nfs : path : /data/nfs server : 192.168.1.100 --- # ============ PVC ============ apiVersion : v1 kind : PersistentVolumeClaim metadata : name : nfs-pvc namespace : default spec : accessModes : - ReadWriteMany # 必须与 PV 的访问模式兼容 resources : requests : storage : 5Gi # 请求 5Gi 存储 storageClassName : nfs # 指定存储类 selector : # 可选:用标签进一步筛选 PV matchLabels : storage : nfs --- # ============ Pod 使用 PVC ============ apiVersion : v1 kind : Pod metadata : name : nfs-pod spec : containers : - name : app image : nginx volumeMounts : - name : data mountPath : /usr/share/nginx/html volumes : - name : data persistentVolumeClaim : claimName : nfs-pvc # 引用 PVC 名称
# ============ 本地存储 StorageClass(使用 Rancher Local Path Provisioner)============ apiVersion : storage.k8s.io/v1 kind : StorageClass metadata : name : local-path annotations : storageclass.kubernetes.io/is-default-class : "true" # 设为默认 provisioner : rancher.io/local-path reclaimPolicy : Delete volumeBindingMode : WaitForFirstConsumer --- # ============ NFS StorageClass(需要安装 nfs-subdir-external-provisioner)============ apiVersion : storage.k8s.io/v1 kind : StorageClass metadata : name : nfs-client provisioner : k8s-sigs.io/nfs-subdir-external-provisioner parameters : archiveOnDelete : "false" --- # ============ PVC 使用动态供应(不引用 PV,自动创建)============ apiVersion : v1 kind : PersistentVolumeClaim metadata : name : dynamic-pvc spec : accessModes : - ReadWriteOnce resources : requests : storage : 10Gi storageClassName : local-path # 指定 StorageClass # 如果不指定 storageClassName,则使用默认 StorageClass
Taint(污点)和 Toleration(容忍)相互配合,用来控制 Pod 的调度:
Taint(污点):打给节点 - 避免 Pod 被分配到不合适的节点上 - 每个节点可以有一个或多个 Taint - 只有能容忍这些污点的 Pod 才能调度到该节点
Toleration(容忍):配给 Pod - 表示该 Pod 可以容忍节点的污点 - 设置了 Toleration 的 Pod 可以被调度到有匹配 Taint 的节点 - Toleration 不意味着一定会调度过去(还要满足其他调度条件)
语法格式: key=value:effect
key:污点标识符(任意字符串) value:污点值(可以为空) effect:污点效果(三个选项)
effect 选项说明: NoSchedule: 不会将 Pod 调度到具有该污点的 Node 上(已有 Pod 不受影响)
PreferNoSchedule: 尽量避免将 Pod 调度到具有该污点的 Node 上(软限制,非保证)
NoExecute: 不会将 Pod 调度到具有该污点的 Node 上 同时会驱逐 Node 上已有的不匹配容忍的 Pod
# 给节点打污点 kubectl taint node < node-nam e> < ke y> = < valu e> : < effec t>
# 示例 kubectl taint node master node-role.kubernetes.io/master=:NoSchedule kubectl taint node node-1 gpu= true :NoSchedule kubectl taint node node-2 disk=ssd:PreferNoSchedule kubectl taint node node-3 dedicated=database:NoExecute
# 删除污点(key 后加 -) kubectl taint node master node-role.kubernetes.io/master:NoSchedule- kubectl taint node node-1 gpu= true :NoSchedule-
# 查看节点污点 kubectl describe node < node-nam e> | grep Taints
# 基础容忍:精确匹配 tolerations : - key : "key1" operator : "Equal" value : "value1" effect : "NoSchedule"
# 带驱逐时间容忍(只对 NoExecute 有效) tolerations : - key : "key1" operator : "Equal" value : "value1" effect : "NoExecute" tolerationSeconds : 3600 # 容忍 3600 秒后才被驱逐
# 特殊容忍类型 1:不指定 value(容忍所有该 key 的污点) tolerations : - key : "key2" operator : "Exists" effect : "NoSchedule"
# 特殊容忍类型 2:不指定 key(容忍所有污点) tolerations : - operator : "Exists"
# 特殊容忍类型 3:不指定 effect(容忍所有 effect) tolerations : - key : "key" operator : "Exists"
# 容忍 master 调度(允许 Pod 调度到 master 节点) tolerations : - key : "node-role.kubernetes.io/master" operator : "Exists" effect : "NoSchedule"
# 防止普通 Pod 资源浪费在 Master 节点上 kubectl taint nodes < Node-Nam e> node-role.kubernetes.io/master=:PreferNoSchedule
# 核心系统 Pod 添加容忍,使其仍可调度到 Master # 如 CoreDNS、kube-proxy 等系统组件默认已有相应容忍
# 直接指定节点名,跳过 Scheduler 调度 # 缺点:节点不存在或不可用时 Pod 无法运行 apiVersion : v1 kind : Pod metadata : name : nginx-nodename spec : nodeName : node-1 # 强制调度到 node-1 containers : - name : nginx image : nginx
# 先给节点打标签 kubectl label node node-1 disktype=ssd kubectl label node node-2 disktype=hdd
# Pod 使用 nodeSelector apiVersion : v1 kind : Pod metadata : name : nginx-nodeselector spec : nodeSelector : disktype : ssd # 只调度到有 disktype=ssd 标签的节点 containers : - name : nginx image : nginx
# 节点亲和性:比 nodeSelector 更强大的调度约束 apiVersion : v1 kind : Pod metadata : name : nginx-affinity spec : affinity : nodeAffinity : # 硬性要求(必须满足) requiredDuringSchedulingIgnoredDuringExecution : nodeSelectorTerms : - matchExpressions : - key : kubernetes.io/os operator : In values : - linux - key : disktype operator : In values : - ssd - nvme # 软性偏好(尽量满足,不保证) preferredDuringSchedulingIgnoredDuringExecution : - weight : 1 # 权重 1-100 preference : matchExpressions : - key : zone operator : In values : - zone-a containers : - name : nginx image : nginx
# Pod 亲和性:尽量将 Pod 调度到一起(如应用与缓存) # Pod 反亲和性:尽量将 Pod 分散调度(如高可用场景) apiVersion : apps/v1 kind : Deployment metadata : name : web-app spec : replicas : 3 selector : matchLabels : app : web template : metadata : labels : app : web spec : affinity : # Pod 反亲和性:分散 web Pod 到不同节点 podAntiAffinity : requiredDuringSchedulingIgnoredDuringExecution : - labelSelector : matchLabels : app : web topologyKey : kubernetes.io/hostname # 按节点分散 # Pod 亲和性:web Pod 尽量靠近 cache Pod podAffinity : preferredDuringSchedulingIgnoredDuringExecution : - weight : 100 podAffinityTerm : labelSelector : matchLabels : app : cache topologyKey : kubernetes.io/hostname containers : - name : nginx image : nginx
Kubernetes 的安全机制围绕 API Server 设计,分为三个阶段:
请求 → [认证 Authentication] → [授权 Authorization] → [准入控制 Admission Control] → 资源操作
1. 认证(Authentication):你是谁? - 验证请求方的身份 - 支持多种认证方式
2. 授权(Authorization):你能做什么? - 验证已认证用户是否有权限执行请求的操作 - 主要使用 RBAC(基于角色的访问控制)
3. 准入控制(Admission Control): - 在请求被持久化之前拦截和修改请求 - 支持 Mutating(修改)和 Validating(验证)两种 Webhook
K8s 支持的认证方式:
1. X509 客户端证书(最常用) - API Server 启动时指定 --client-ca-file - 客户端使用由该 CA 签发的证书
2. Bearer Token(静态 Token 文件) - API Server 启动时指定 --token-auth-file - 格式:token,user,uid,"group1,group2" - 安全性较低,不推荐生产使用
3. Bootstrap Token(启动引导令牌) - 用于新节点加入集群 - 存储在 kube-system 命名空间的 Secret 中
4. Service Account Token(服务账户令牌) - Pod 内部访问 API Server 时使用 - 自动挂载到 Pod 的 /var/run/secrets/kubernetes.io/serviceaccount/
5. OpenID Connect(OIDC) - 集成外部身份提供商(如 Google、Azure AD、Dex)
6. Webhook Token 认证 - 将认证请求转发到外部服务验证
# ~/.kube/config apiVersion : v1 kind : Config clusters : - cluster : certificate-authority-data : <CA证书Base64> server : https://192.168.1.100:6443 name : kubernetes contexts : - context : cluster : kubernetes user : admin name : admin@kubernetes current-context : admin@kubernetes users : - name : admin user : client-certificate-data : <客户端证书Base64> client-key-data : <客户端私钥Base64>
- clusters:集群信息(CA 证书、API Server 地址)
- users:客户端认证信息(证书和私钥、或 Token)
- contexts:将 cluster 和 user 绑定的上下文
- current-context:当前使用的上下文
Kubernetes 组件通过指定不同的 kubeconfig 文件可以切换到不同集群。
RBAC 四个核心对象:
1. Role / ClusterRole(角色): - 定义一组权限规则(对特定 API 资源的操作许可) - Role:命名空间级别 - ClusterRole:集群级别(包括集群级资源和非资源 URL)
2. RoleBinding / ClusterRoleBinding(角色绑定): - 将 Role/ClusterRole 绑定到用户、组或 ServiceAccount - RoleBinding:命名空间级别 - ClusterRoleBinding:集群级别
3. Subject(主体): - 被授权的对象:User、Group、ServiceAccount
4. ServiceAccount(服务账户): - Pod 内部访问 API Server 使用的身份 - 每个命名空间默认有一个 default ServiceAccount
2. ServiceAccount:由 K8s API 管理
证书中定义用户信息:
配置 CN(Common Name)= 用户名
配置 O(Organization)= 用户组
{ "CN" : "admin" , "hosts" : [], "key" : { "algo" : "rsa" , "size" : 2048 }, "names" : [ { "C" : "CN" , "ST" : "HangZhou" , "L" : "XS" , "O" : "system:masters" , // 用户组 "OU" : "System" } ] }
# ============ Role:命名空间级权限 ============ apiVersion : rbac.authorization.k8s.io/v1 kind : Role metadata : namespace : default name : pod-reader rules : - apiGroups : [ "" ] # 核心 API 组 resources : [ "pods" ] # 资源类型 verbs : [ "get" , "watch" , "list" ] # 操作权限 - apiGroups : [ "" ] resources : [ "pods/log" ] verbs : [ "get" , "list" ] --- # ============ ClusterRole:集群级权限 ============ apiVersion : rbac.authorization.k8s.io/v1 kind : ClusterRole metadata : name : secret-reader rules : - apiGroups : [ "" ] resources : [ "secrets" ] verbs : [ "get" , "watch" , "list" ] --- # ============ RoleBinding:绑定到 ServiceAccount ============ apiVersion : rbac.authorization.k8s.io/v1 kind : RoleBinding metadata : name : read-pods namespace : default subjects : - kind : ServiceAccount name : myapp-sa # 目标 ServiceAccount namespace : default - kind : User # 或直接绑定给用户 name : "zhangsan" - kind : Group # 或绑定给用户组 name : "developers" roleRef : kind : Role name : pod-reader # 绑定的角色 apiGroup : rbac.authorization.k8s.io --- # ============ ClusterRoleBinding ============ apiVersion : rbac.authorization.k8s.io/v1 kind : ClusterRoleBinding metadata : name : read-secrets-global subjects : - kind : Group name : managers apiGroup : rbac.authorization.k8s.io roleRef : kind : ClusterRole name : secret-reader apiGroup : rbac.authorization.k8s.io
# ============ 创建 ServiceAccount ============ apiVersion : v1 kind : ServiceAccount metadata : name : myapp-sa namespace : default --- # ============ Pod 使用指定的 ServiceAccount ============ apiVersion : v1 kind : Pod metadata : name : myapp spec : serviceAccountName : myapp-sa # 指定 SA(不指定则用 default) containers : - name : app image : myapp:v1
# 创建 ServiceAccount kubectl create serviceaccount myapp-sa -n default
# 查看 ServiceAccount kubectl get sa -n default kubectl get sa myapp-sa -n default -o yaml # 查看详情
# 删除 ServiceAccount kubectl delete sa myapp-sa -n default
--- # ========== 1. 创建命名空间 ========== apiVersion : v1 kind : Namespace metadata : name : dev-team --- # ========== 2. 创建 ServiceAccount ========== apiVersion : v1 kind : ServiceAccount metadata : name : cicd-deployer namespace : dev-team --- # ========== 3. 创建 Role(命名空间级权限)========== apiVersion : rbac.authorization.k8s.io/v1 kind : Role metadata : name : deployer-role namespace : dev-team rules : - apiGroups : [ "apps" ] resources : [ "deployments" ] verbs : [ "get" , "list" , "watch" , "create" , "update" , "patch" ] - apiGroups : [ "" ] resources : [ "pods" , "services" , "configmaps" ] verbs : [ "get" , "list" , "watch" , "create" , "update" , "delete" ] --- # ========== 4. 创建 RoleBinding ========== apiVersion : rbac.authorization.k8s.io/v1 kind : RoleBinding metadata : name : deployer-binding namespace : dev-team subjects : - kind : ServiceAccount name : cicd-deployer namespace : dev-team roleRef : kind : Role name : deployer-role apiGroup : rbac.authorization.k8s.io --- # ========== 5. 手动创建 Secret(v1.24+ 必须手动创建)========== apiVersion : v1 kind : Secret metadata : name : cicd-deployer-token namespace : dev-team annotations : kubernetes.io/service-account.name : cicd-deployer # 关键:绑定到 SA type : kubernetes.io/service-account-token
# 应用 YAML 文件 kubectl apply -f rbac/cicd-deployer.yaml
# 等待 Secret 生成 Token(通常瞬间完成) kubectl describe secret cicd-deployer-token -n dev-team
# 获取 Token kubectl get secret cicd-deployer-token -n dev-team \ -o jsonpath='{.data.token}' | base64 -d
# 获取 CA 证书(用于配置 kubeconfig) kubectl get secret cicd-deployer-token -n dev-team \ -o jsonpath='{.data.ca\.crt}' | base64 -d > ca.crt
--- # ========== 1. 创建命名空间 ========== apiVersion : v1 kind : Namespace metadata : name : prod-team --- # ========== 2. 创建 ServiceAccount ========== # v1.23 及以下:创建 SA 时自动生成 Secret,无需手动创建 apiVersion : v1 kind : ServiceAccount metadata : name : prod-deployer namespace : prod-team --- # ========== 3. 创建 Role ========== apiVersion : rbac.authorization.k8s.io/v1 kind : Role metadata : name : prod-deployer-role namespace : prod-team rules : - apiGroups : [ "apps" ] resources : [ "deployments" ] verbs : [ "get" , "list" , "watch" , "create" , "update" , "patch" ] - apiGroups : [ "" ] resources : [ "pods" , "services" ] verbs : [ "get" , "list" , "watch" , "create" , "update" , "delete" ] --- # ========== 4. 创建 RoleBinding ========== apiVersion : rbac.authorization.k8s.io/v1 kind : RoleBinding metadata : name : prod-deployer-binding namespace : prod-team subjects : - kind : ServiceAccount name : prod-deployer namespace : prod-team roleRef : kind : Role name : prod-deployer-role apiGroup : rbac.authorization.k8s.io
# 应用 YAML 文件 kubectl apply -f rbac/prod-deployer.yaml
# SA 会自动创建 Secret,查看 Secret 名称 kubectl get sa prod-deployer -n prod-team -o jsonpath='{.secrets[0].name}' # 输出:prod-deployer-token-xxxxx
# 获取自动生成的 Secret 名称并提取 Token SECRET_NAME = $( kubectl get sa prod-deployer -n prod-team \ -o jsonpath='{.secrets[0].name}' ) kubectl get secret $SECRET_NAME -n prod-team \ -o jsonpath='{.data.token}' | base64 -d
# 获取 CA 证书 kubectl get secret $SECRET_NAME -n prod-team \ -o jsonpath='{.data.ca\.crt}' | base64 -d > ca.crt
--- # ========== 追加:手动创建 Secret 绑定 SA ========== apiVersion : v1 kind : Secret metadata : name : prod-deployer-token namespace : prod-team annotations : kubernetes.io/service-account.name : prod-deployer type : kubernetes.io/service-account-token
# ==================== 完整操作流程 ====================
# 步骤 1:创建命名空间 kubectl create namespace dev-team
# 步骤 2:创建 ServiceAccount kubectl create serviceaccount cicd-deployer -n dev-team
# 步骤 3:创建 Role kubectl create role deployer-role \ --namespace=dev-team \ --verb=get,list,watch,create,update,patch \ --resource=deployments --resource=pods --resource=services \ --resource=configmaps
# 步骤 4:创建 RoleBinding kubectl create rolebinding deployer-binding \ --namespace=dev-team \ --role=deployer-role \ --serviceaccount=dev-team:cicd-deployer
# 步骤 5:生成 Token(v1.24+ 推荐方式) # --duration: Token 有效期(默认 1h,示例设为 720h=30天) kubectl create token cicd-deployer -n dev-team --duration=720h
# 输出示例: # eyJhbGciOiJSUzI1NiIsImtpZCI6ImFiY2QxMjM0...
# ============ 常用选项 ============ # 长有效期 Token(最长可设数年) kubectl create token cicd-deployer -n dev-team --duration=87600h # 约 10 年
# 短期 Token kubectl create token cicd-deployer -n dev-team --duration=24h
# 输出到文件 kubectl create token cicd-deployer -n dev-team --duration=720h > cicd-token.txt
# 绑定特定对象 kubectl create token cicd-deployer -n dev-team --duration=24h \ --bound-object-kind=Pod --bound-object-name=my-pod
# ==================== 完整操作流程 ====================
# 步骤 1:创建命名空间 kubectl create namespace prod-team
# 步骤 2:创建 ServiceAccount(自动生成 Secret) kubectl create serviceaccount prod-deployer -n prod-team
# 步骤 3:创建 Role kubectl create role prod-deployer-role \ --namespace=prod-team \ --verb=get,list,watch,create,update,patch,delete \ --resource=deployments --resource=pods --resource=services
# 步骤 4:创建 RoleBinding kubectl create rolebinding prod-deployer-binding \ --namespace=prod-team \ --role=prod-deployer-role \ --serviceaccount=prod-team:prod-deployer
# 步骤 5:获取自动生成的 Secret 名称 SECRET_NAME = $( kubectl get sa prod-deployer -n prod-team \ -o jsonpath='{.secrets[0].name}' ) echo "Secret: $SECRET_NAME "
# 步骤 6:获取 Token kubectl get secret $SECRET_NAME -n prod-team \ -o jsonpath='{.data.token}' | base64 -d
# 步骤 7:获取 CA 证书 kubectl get secret $SECRET_NAME -n prod-team \ -o jsonpath='{.data.ca\.crt}' | base64 -d > ca.crt
#!/bin/bash # ==================== 生成独立 kubeconfig 文件 ==================== # 用法:./gen-kubeconfig.sh <namespace> <sa-name> <token> [output-file]
NAMESPACE = ${1 :- dev-team } SA_NAME = ${2 :- cicd-deployer } SA_TOKEN = ${3} OUTPUT = ${4 :-${ SA_NAME }. kubeconfig }
if [ -z " $SA_TOKEN " ]; then echo "用法: $0 <namespace> <sa-name> <token> [output-file]" exit 1 fi
# 1. 获取集群信息 APISERVER = $( kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}' ) CLUSTER_NAME = $( kubectl config view --minify -o jsonpath='{.clusters[0].name}' )
echo "API Server: $APISERVER " echo "Cluster: $CLUSTER_NAME "
# 2. 获取 CA 证书 # 方式 A:从集群 kubeconfig 获取(推荐,不需要 Secret 资源) CA_DATA = $( kubectl config view --raw -o jsonpath='{.clusters[0].cluster.certificate-authority-data}' ) if [ -z " $CA_DATA " ]; then # 方式 B:尝试从 ConfigMap 获取 CA_DATA = $( kubectl get configmap kube-root-ca.crt -n kube-system \ -o jsonpath='{.data.ca\.crt}' 2> /dev/null | base64 -w 0 ) if [ -z " $CA_DATA " ]; then echo "错误:无法获取 CA 证书" exit 1 fi fi
# 3. 生成 kubeconfig kubectl config set-cluster "${ CLUSTER_NAME }" \ --server= " $APISERVER " \ --certificate-authority-data= " $CA_DATA " \ --embed-certs=true \ --kubeconfig= " $OUTPUT "
kubectl config set-credentials "${ SA_NAME }" \ --token= " $SA_TOKEN " \ --kubeconfig= " $OUTPUT "
kubectl config set-context "${ SA_NAME }@${ CLUSTER_NAME }" \ --cluster= "${ CLUSTER_NAME }" \ --user= "${ SA_NAME }" \ --namespace= " $NAMESPACE " \ --kubeconfig= " $OUTPUT "
kubectl config use-context "${ SA_NAME }@${ CLUSTER_NAME }" \ --kubeconfig= " $OUTPUT "
echo "kubeconfig 已生成: $OUTPUT "
# 4. 验证 kubeconfig kubectl get pods -n " $NAMESPACE " --kubeconfig= " $OUTPUT " 2>&1 echo "---" kubectl auth can-i create deployments -n " $NAMESPACE " --kubeconfig= " $OUTPUT "
echo "" echo "使用者配置方式:" echo " export KUBECONFIG=$( realpath $OUTPUT )" echo " 或复制到 ~/.kube/config 合并使用"
# ====== 手动步骤(不使用脚本) ======
# 1. 获取集群信息 APISERVER = $( kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}' )
# 2. 获取 CA 证书(方式 B:从 Secret 中提取) kubectl get secret < secret-nam e> -n < namespac e> \ -o jsonpath='{.data.ca\.crt}' | base64 -d > /tmp/cluster-ca.crt
# 3. 生成 kubeconfig SA_NAME = "cicd-deployer" NAMESPACE = "dev-team" SA_TOKEN = "eyJhbGciOiJSUzI1NiIs..."
kubectl config set-cluster my-cluster \ --server= $APISERVER \ --certificate-authority=/tmp/cluster-ca.crt \ --embed-certs=true \ --kubeconfig=cicd-deployer.kubeconfig
kubectl config set-credentials $SA_NAME \ --token= $SA_TOKEN \ --kubeconfig=cicd-deployer.kubeconfig
kubectl config set-context ${ SA_NAME } @my-cluster \ --cluster=my-cluster \ --user= $SA_NAME \ --namespace= $NAMESPACE \ --kubeconfig=cicd-deployer.kubeconfig
kubectl config use-context ${ SA_NAME } @my-cluster \ --kubeconfig=cicd-deployer.kubeconfig
# 4. 验证 kubectl get pods -n $NAMESPACE --kubeconfig=cicd-deployer.kubeconfig kubectl auth can-i create deployments -n $NAMESPACE \ --kubeconfig=cicd-deployer.kubeconfig
Ingress 是 K8s 的 HTTP/HTTPS 路由规则集合,为集群外部访问提供统一的入口:
作用: - 提供外部可访问的 URL(基于域名或路径) - 负载均衡流量 - SSL/TLS 终止 - 基于名称的虚拟主机
Ingress 工作流程: 外部请求 → Ingress Controller(如 Nginx Ingress)→ Ingress 规则 → 后端 Service → Pod
核心组件: - Ingress 资源:定义路由规则 - Ingress Controller:实际执行路由规则的组件(需要单独安装)
# ============ 简单 Ingress ============ apiVersion : networking.k8s.io/v1 kind : Ingress metadata : name : minimal-ingress annotations : nginx.ingress.kubernetes.io/rewrite-target : / spec : ingressClassName : nginx # 指定 Ingress Controller rules : - host : myapp.example.com # 域名 http : paths : - path : / # 路径 pathType : Prefix # Prefix / Exact / ImplementationSpecific backend : service : name : myapp-service # 后端 Service port : number : 8080
--- # ============ 多路径 Ingress ============ apiVersion : networking.k8s.io/v1 kind : Ingress metadata : name : multi-path-ingress spec : ingressClassName : nginx rules : - host : api.example.com http : paths : - path : /users pathType : Prefix backend : service : name : user-service port : number : 80 - path : /orders pathType : Prefix backend : service : name : order-service port : number : 80
--- # ============ TLS Ingress ============ apiVersion : networking.k8s.io/v1 kind : Ingress metadata : name : tls-ingress spec : ingressClassName : nginx tls : - hosts : - secure.example.com secretName : tls-secret # 包含证书和私钥的 Secret rules : - host : secure.example.com http : paths : - path : / pathType : Prefix backend : service : name : myapp-service port : number : 443
# 安装 Nginx Ingress Controller(使用 Helm) helm repo add ingress-nginx https://kubernetes.github.io/ingress-nginx helm repo update helm install ingress-nginx ingress-nginx/ingress-nginx \ --namespace ingress-nginx \ --create-namespace
# 或使用 kubectl 直接安装 kubectl apply -f https://raw.githubusercontent.com/kubernetes/ingress-nginx/main/deploy/static/provider/cloud/deploy.yaml
# 验证安装 kubectl get pods -n ingress-nginx kubectl get svc -n ingress-nginx
apiVersion : v1 kind : Pod metadata : name : resource-demo spec : containers : - name : app image : nginx resources : requests : # 调度时保证的最小资源 cpu : "250m" # 250 millicores = 0.25 CPU memory : "128Mi" limits : # 运行时允许的最大资源 cpu : "500m" memory : "256Mi"
CPU: - 1 核 = 1000m(millicores) - 0.5 核 = 500m - 可以写 1 或 1000m
内存: - 单位:Ki、Mi、Gi、Ti - 1Mi = 1024Ki = 1048576 bytes - 也可以写纯数字(字节),如 134217728
QoS 等级(由 requests 和 limits 决定): - Guaranteed:requests == limits(最高优先级,最不容易被驱逐) - Burstable:requests < limits - BestEffort:无 requests 和 limits(最低优先级,最先被驱逐)
apiVersion : autoscaling/v2 kind : HorizontalPodAutoscaler metadata : name : myapp-hpa namespace : default spec : scaleTargetRef : apiVersion : apps/v1 kind : Deployment name : myapp-deployment minReplicas : 2 maxReplicas : 10 metrics : - type : Resource resource : name : cpu target : type : Utilization averageUtilization : 70 # 目标 CPU 使用率 70% - type : Resource resource : name : memory target : type : Utilization averageUtilization : 80 # 目标内存使用率 80% behavior : scaleDown : stabilizationWindowSeconds : 300 # 缩容稳定窗口 5 分钟 scaleUp : stabilizationWindowSeconds : 0 # 扩容即时响应
# 限制命名空间的资源总量 apiVersion : v1 kind : ResourceQuota metadata : name : compute-quota namespace : dev spec : hard : requests.cpu : "10" requests.memory : 20Gi limits.cpu : "20" limits.memory : 40Gi persistentvolumeclaims : "10" pods : "50" services : "10" configmaps : "20" secrets : "20"
# 为命名空间中的 Pod/容器设置默认的资源限制 apiVersion : v1 kind : LimitRange metadata : name : default-limits namespace : dev spec : limits : - type : Container default : cpu : "500m" memory : "256Mi" defaultRequest : cpu : "100m" memory : "128Mi" max : cpu : "2" memory : "2Gi" min : cpu : "50m" memory : "64Mi"
# ==================== 集群管理 ==================== # 查看集群组件状态 kubectl get componentstatuses # 或 kubectl get cs
# 查看集群事件(按时间排序) kubectl get events -A --sort-by= '.metadata.creationTimestamp'
# 查看所有命名空间中资源使用情况 kubectl top nodes kubectl top pods -A --sort-by=cpu kubectl top pods -A --sort-by=memory
# ==================== 故障排查 ==================== # 查看 Pod 的事件和状态 kubectl describe pod < pod-nam e> -n < namespac e>
# 查看 Pod 启动失败原因 kubectl get events -n < namespac e> --sort-by= '.lastTimestamp' | grep < pod-nam e>
# 查看容器退出日志 kubectl logs < pod-nam e> -c < containe r> --previous
# 在 Pod 中调试 kubectl run debug-pod --rm -it --image=busybox -- /bin/sh # 临时调试 Pod kubectl debug -it < pod-nam e> --image=busybox --target= < container > # 挂到已有 Pod
# ==================== 网络调试 ==================== # 测试 Service DNS kubectl run -it --rm dns-test --image=busybox -- nslookup < service-nam e>
# 测试 Service 连通性 kubectl run -it --rm curl-test --image=curlimages/curl -- curl http:// < service-nam e> : < por t>
# 查看 Endpoints kubectl get endpoints -A
# ==================== 配置管理 ==================== # 生成 YAML 模板 kubectl create deployment nginx --image=nginx --dry-run=client -o yaml > deploy.yaml kubectl create configmap my-config --from-literal=key=value --dry-run=client -o yaml
# 导出在线资源 kubectl get deployment < nam e> -o yaml > deploy-backup.yaml
# 批量替换 kubectl get pods -l app=oldapp -o name | xargs -I {} kubectl label {} app=newapp --overwrite
# ==================== 权限调试 ==================== # 检查当前用户权限 kubectl auth can-i create pods --namespace=default kubectl auth can-i '*' '*' --as=system:serviceaccount:default:myapp-sa
# 查看角色绑定 kubectl get rolebindings,clusterrolebindings -A
# ==================== 证书管理 ==================== # 查看证书过期时间 kubectl get secret -n kube-system -o jsonpath='{.items[*].data}' | \ while read data ; do echo $data | base64 -d | openssl x509 -noout -enddate 2> /dev/null ; done
假设你在运维一个 Redis 集群。没有 CRD 时,你需要: 手写 Deployment + ConfigMap + Service(散落的资源文件) 通过注释或 Label 标记"这些资源属于同一个 Redis 集群" 扩容缩容需要手动改 Deployment 副本数 + 更新 ConfigMap 节点列表
有了 CRD 后,你可以定义: apiVersion: cache.example.com/v1 kind: RedisCluster metadata: name: my-redis spec: replicas: 3 memory: "2Gi" version: "7.0"
一条命令创建整个 Redis 集群,Operator 自动帮你去生成 Deployment、ConfigMap、Service、PVC 等底层资源。
apiVersion : apiextensions.k8s.io/v1 kind : CustomResourceDefinition metadata : name : redisclusters.cache.example.com # 命名规则:<plural>.<group> # ↑ 推荐用小写复数形式 ↑ 自定义的 API Group spec : # ===== 1. 组信息 ===== group : cache.example.com # API Group 名称 # 最终 API 路径:/apis/cache.example.com/v1/...
# ===== 2. 资源名称和简称 ===== names : kind : RedisCluster # Go/CamelCase 资源类型名 listKind : RedisClusterList # 列表类型名(kind + List) plural : redisclusters # 复数形式(出现在 URL 路径中) singular : rediscluster # 单数形式(kubectl get rediscluster) shortNames : # 短名称(可选) # 应用 CRD 定义 kubectl apply -f crd/rediscluster-crd.yaml
# 验证 CRD 已注册 kubectl get crd # NAME CREATED AT # redisclusters.cache.example.com 2026-01-01T00:00:00Z
# 查看 CRD 详情 kubectl describe crd redisclusters.cache.example.com
# 查看 CRD 的 API 资源路径 kubectl api-resources | grep rediscluster # NAME SHORTNAMES APIVERSION NAMESPACED KIND # redisclusters rc cache.example.com/v1 true RedisCluster
# 查看 CRD 的原始 API 发现信息 kubectl get --raw /apis/cache.example.com/v1 | jq .
apiVersion : cache.example.com/v1 # CRD 定义的 group + version kind : RedisCluster # CRD 定义的 kind metadata : name : my-redis # CR 实例名称 namespace : default spec : replicas : 3 memory : "2Gi" version : "7.0" persistence : enabled : true storageSize : "10Gi" nodeSelector : disktype : ssd # 只调度到 SSD 节点 tls : enabled : false
# 创建自定义资源 kubectl apply -f cr/my-redis.yaml
# 查看自定义资源 kubectl get redisclusters # 或简写 kubectl get rc # NAME REPLICAS READY VERSION PHASE AGE # my-redis 3 7.0 5s
kubectl get rc # 使用 shortName kubectl get rediscluster my-redis -o yaml # 查看完整内容
# 编辑 CR kubectl edit rediscluster my-redis
# 删除 CR kubectl delete rediscluster my-redis
# 测试校验规则——尝试写不合法数据 kubectl apply -f - << EOF apiVersion: cache.example.com/v1 kind: RedisCluster metadata: name: bad-redis spec: replicas: 0 # 最小值校验失败(minimum: 1) version: "5.0" # 枚举校验失败(不是 6.2/7.0/7.2) EOF
# API Server 会拒绝并返回清晰的错误信息: # The RedisCluster "bad-redis" is invalid: # * spec.replicas: Invalid value: 0: spec.replicas in body should be greater than or equal to 1 # * spec.version: Unsupported value: "5.0": supported values: "6.2", "7.0", "7.2"
spec : group : cache.example.com versions : - name : v1alpha1 # 早期实验版本 served : true # API 端点可用 storage : false # 不存储在 etcd(仅从 v1 转换) schema : ... subresources : {} - name : v1beta1 # 测试版本 served : true storage : false schema : ... subresources : {} - name : v1 # 稳定版本 served : true storage : true # 只有 v1 存储在 etcd schema : ... subresources : status : {} scale : {} conversion : strategy : Webhook # 需要版本转换的 Webhook 服务 webhook : conversionReviewVersions : [ "v1" , "v1beta1" , "v1alpha1" ] clientConfig : service : namespace : cache-system name : redis-operator-webhook path : /convert
# CR 被标记删除时,metadata.deletionTimestamp 被设置,但资源不会立即消失 apiVersion : cache.example.com/v1 kind : RedisCluster metadata : name : my-redis finalizers : - cache.example.com/finalizer # 自定义 Finalizer - foregroundDeletion # K8s 内置 Finalizer(级联删除时使用) spec : replicas : 3
deletionTimestamp
执行清理逻辑(卸载数据卷、通知外部系统、备份数据...)
清理完成后,从 finalizers
所有 finalizer 被移除后,API Server 才真正删除 etcd 中的数据 ServiceMonitor
Alertmanager
Istio VirtualService DestinationRule Gateway 服务网格流量管理
Argo CD Application AppProject GitOps 持续部署
Crossplane RDSInstance Bucket VPC 用 K8s 管理云资源(RDS、S3 等)
Sealed Secrets SealedSecret 加密 Secret 可安全提交到 Git
Strimzi Kafka KafkaTopic KafkaUser 声明式管理 Kafka 集群
ingress-nginx VirtualServer TransportServer Nginx Ingress 高级路由
┌──────────────────────────────────────────────────────────┐ │ Operator 工具链层级关系 │ ├──────────────────────────────────────────────────────────┤ │ │ │ ┌──────────────────────────────────────────────────┐ │ │ │ Operator SDK / Kubebuilder │ │ │ │ (脚手架:生成 CRD + Controller 代码) │ │ │ └──────────────────┬───────────────────────────────┘ │ │ │ 基于 │ │ ▼ │ │ ┌──────────────────────────────────────────────────┐ │ │ │ controller-runtime │ │ │ │ (K8s SIG 维护的核心控制器框架) │ │ │ └──────────────────┬───────────────────────────────┘ │ │ │ 基于 │ │ ▼ │ │ ┌──────────────────────────────────────────────────┐ │ │ │ client-go │ │ │ │ (K8s 官方 Go 客户端库) │ │ │ └──────────────────────────────────────────────────┘ │ │ │ └──────────────────────────────────────────────────────────┘
# ===== 1. 安装 Kubebuilder ===== # macOS brew install kubebuilder # Linux curl -L https://github.com/kubernetes-sigs/kubebuilder/releases/latest/download/kubebuilder_linux_amd64 -o kubebuilder chmod +x kubebuilder && sudo mv kubebuilder /usr/local/bin/
# ===== 2. 创建项目 ===== mkdir redis-operator && cd redis-operator kubebuilder init --domain example.com --repo github.com/example/redis-operator
# 项目结构: # ├── cmd/main.go # 入口 # ├── config/ # Kustomize 部署配置 # │ ├── crd/ # CRD YAML(由工具自动生成) # │ ├── rbac/ # RBAC 标记生成的 ClusterRole # │ └── manager/ # Operator 自身的 Deployment # ├── api/ # API 类型定义(CRD 的 Go 结构体) # │ └── v1/ # │ ├── groupversion_info.go # Group + Version 注册 # │ ├── rediscluster_types.go # CRD Go 类型定义 # │ └── zz_generated.deepcopy.go # 自动生成的 DeepCopy 方法 # └── internal/controller/ # Controller 逻辑 # └── rediscluster_controller.go # Reconcile 函数在这里
# ===== 3. 创建 API(CRD 类型) ===== kubebuilder create api \ --group cache \ --version v1 \ --kind RedisCluster \ --resource true \ # 生成 CRD 类型 --controller true # 生成 Controller
# ===== 4. 编辑 Go 类型定义(api/v1/rediscluster_types.go) ===== # 在 Spec 和 Status 结构体中添加需要的字段 # 运行 make generate 自动生成 DeepCopy 和 CRD YAML
# ===== 5. 编写 Reconcile 逻辑(internal/controller/...) ===== # 实现核心控制循环
# ===== 6. 构建和运行 ===== make generate # 生成代码(deepcopy, CRD YAML) make manifests # 生成 K8s YAML(CRD, RBAC, Webhook) make install # 安装 CRD 到集群 make run # 本地运行 Operator(开发模式)
# ===== 7. 构建镜像并部署 ===== make docker-build docker-push IMG=myrepo/redis-operator:v0.1.0 make deploy IMG=myrepo/redis-operator:v0.1.0
// internal/controller/rediscluster_controller.go // ⚠ 这是骨架示例,展示核心流程,不可直接运行
package controller
import ( "context" "fmt"
appsv1 "k8s.io/api/apps/v1" corev1 "k8s.io/api/core/v1" "k8s.io/apimachinery/pkg/api/errors" metav1 "k8s.io/apimachinery/pkg/apis/meta/v1" "k8s.io/apimachinery/pkg/runtime" ctrl "sigs.k8s.io/controller-runtime" "sigs.k8s.io/controller-runtime/pkg/client" "sigs.k8s.io/controller-runtime/pkg/log"
cachev1 "github.com/example/redis-operator/api/v1" )
// RedisClusterReconciler 是 Controller 的核心结构体 type RedisClusterReconciler struct { client . Client // K8s client:用于读写资源 Scheme * runtime . Scheme Status().Update()
Update()
OwnerReference
Owns() // +kubebuilder:rbac:groups=cache.example.com,resources=redisclusters,verbs=get;list;watch;create;update;patch;delete // +kubebuilder:rbac:groups=cache.example.com,resources=redisclusters/status,verbs=get;update;patch
// 子资源的权限也要声明 // +kubebuilder:rbac:groups=apps,resources=statefulsets,verbs=get;list;watch;create;update;patch;delete // +kubebuilder:rbac:groups="",resources=services,verbs=get;list;watch;create;update;patch;delete // +kubebuilder:rbac:groups="",resources=configmaps,verbs=get;list;watch;create;update;patch;delete // +kubebuilder:rbac:groups="",resources=events,verbs=create;patch // ★ 创建事件(用于记录日志到 kubectl describe)
# 运行 make manifests 后自动生成 RBAC YAML make manifests # 生成的文件:config/rbac/role.yaml
# 查看 Operator 需要的权限 kubectl describe clusterrole redis-operator-role
# 以 Strimzi Kafka Operator 为例,使用方式: # 1. 安装 Operator kubectl create namespace kafka kubectl apply -f https://strimzi.io/install/latest?namespace=kafka
# 2. 创建 Kafka CR cat << EOF | kubectl apply -n kafka -f - apiVersion: kafka.strimzi.io/v1beta2 kind: Kafka metadata: name: my-cluster spec: kafka: version: 3.6.0 replicas: 3 listeners: - name: plain port: 9092 type: internal tls: false - name: tls port: 9093 type: internal tls: true storage: type: jbod volumes: - id: 0 type: persistent-claim size: 100Gi deleteClaim: false zookeeper: replicas: 3 storage: type: persistent-claim size: 100Gi deleteClaim: false EOF
# 3. Operator 自动创建 Kafka + ZooKeeper 集群 kubectl get pods -n kafka -w # my-cluster-kafka-0 2/2 Running # my-cluster-kafka-1 2/2 Running # my-cluster-kafka-2 2/2 Running # my-cluster-zookeeper-0 1/1 Running # my-cluster-zookeeper-1 1/1 Running # my-cluster-zookeeper-2 1/1 Running
# 一行 YAML,一套完整 Kafka 生产集群!
- rc # kubectl get rc 也能查到这个 CRD
categories : # 归类(可选,kubectl get <category> 会包含此资源)
- cache # kubectl get cache 列出所有 category=cache 的资源
# ===== 3. 作用域 =====
scope : Namespaced # Namespaced(命名空间级)或 Cluster(集群级)
# Cluster 级别的 CRD 不受命名空间限制,如证书、节点配置等
# ===== 4. 版本定义(★ 最重要部分) =====
versions :
- name : v1 # 版本号
served : true # 是否对外提供此版本
storage : true # 是否为存储版本(etcd 中持久化的版本,有且只有一个版本为 true)
# ----- 4a. Schema 校验(OpenAPI v3) -----
schema :
openAPIV3Schema :
type : object
required : # 必填字段
- spec
properties :
# --- spec 字段定义 ---
spec :
type : object
required :
- replicas
properties :
replicas :
type : integer
description : "Redis 实例副本数"
minimum : 1 # 最小值校验
maximum : 10 # 最大值校验
memory :
type : string
description : "每个实例内存限制(如 2Gi)"
pattern : '^[0-9]+(Mi|Gi|Ti)$' # 正则校验:必须为数字 + 单位
default : "1Gi" # 默认值
version :
type : string
description : "Redis 版本号"
enum : # 枚举值限制
- "6.2"
- "7.0"
- "7.2"
persistence :
type : object
description : "持久化配置"
properties :
enabled :
type : boolean
default : false
storageSize :
type : string
pattern : '^[0-9]+(Gi|Ti)$'
nodeSelector :
type : object
description : "节点选择器"
additionalProperties : # 允许任意 key=value 的字符串对
type : string
tls :
type : object
properties :
enabled :
type : boolean
default : false
secretName :
type : string
# --- status 字段定义 ---
status :
type : object
properties :
phase :
type : string
description : "集群当前状态"
enum :
- Pending
- Creating
- Running
- Updating
- Failed
readyReplicas :
type : integer
description : "就绪的副本数量"
endpoints :
type : array
description : "可用的连接端点"
items :
type : string
conditions :
type : array
description : "详细状态条件"
items :
type : object
properties :
type :
type : string
status :
type : string
enum : [ "True" , "False" , "Unknown" ]
lastTransitionTime :
type : string
format : date-time
reason :
type : string
message :
type : string
# ----- 4b. 子资源(Subresources) -----
subresources :
status : {} # 启用 /status 子资源
# 作用:让 Operator 更新 status 时不需要更新整个 CR
# 用法:kubectl 操作时 spec 和 status 分离校验
scale : # 启用 /scale 子资源(支持 kubectl scale)
specReplicasPath : .spec.replicas # 指定 spec 中控制副本数量的字段路径
statusReplicasPath : .status.readyReplicas # 指定 status 中就绪副本数的字段路径
labelSelectorPath : .status.labelSelector
# ----- 4c. 打印列(kubectl get 额外列) -----
additionalPrinterColumns :
- name : REPLICAS # 列标题
type : integer # 列数据类型
description : "所需副本数"
jsonPath : .spec.replicas # JSONPath 指定数据来源
- name : READY
type : integer
jsonPath : .status.readyReplicas
- name : VERSION
type : string
jsonPath : .spec.version
- name : PHASE
type : string
jsonPath : .status.phase
- name : AGE
type : date
jsonPath : .metadata.creationTimestamp
# ===== 5. 转换策略(多版本共存时使用) =====
conversion :
strategy : None # None: 不做版本转换(每个版本独立存储)
# Webhook: 通过 Webhook 服务进行版本转换(支持多版本 CR)
}
// +kubebuilder:rbac:groups=cache.example.com,resources=redisclusters,verbs=get;list;watch;create;update;patch;delete
// +kubebuilder:rbac:groups=cache.example.com,resources=redisclusters/status,verbs=get;update;patch
// +kubebuilder:rbac:groups=apps,resources=deployments,verbs=get;list;watch;create;update;patch;delete
// Reconcile 方法是整个 Operator 的核心
func ( r * RedisClusterReconciler ) Reconcile ( ctx context . Context , req ctrl . Request ) ( ctrl . Result , error ) {
logger := log . FromContext ( ctx )
// ===== 步骤 1:获取 CR(期望状态) =====
var redisCluster cachev1 . RedisCluster
if err := r . Get ( ctx , req . NamespacedName , & redisCluster ); err != nil {
if errors . IsNotFound ( err ) {
// CR 被删除了——清理相关资源(或者什么都不做)
logger . Info ( "RedisCluster 被删除,无需处理" )
return ctrl . Result {}, nil // 返回 nil 表示不重新入队
}
// 其他错误:重新入队等待重试
return ctrl . Result {}, err
}
// ===== 步骤 2:处理 Finalizer(安全删除逻辑) =====
finalizerName := "cache.example.com/finalizer"
if redisCluster . DeletionTimestamp . IsZero () {
// CR 没有被删除——确保 Finalizer 存在
if ! containsString ( redisCluster . Finalizers , finalizerName ) {
redisCluster . Finalizers = append ( redisCluster . Finalizers , finalizerName )
if err := r . Update ( ctx , & redisCluster ); err != nil {
return ctrl . Result {}, err
}
}
} else {
// CR 正在被删除——执行清理
if containsString ( redisCluster . Finalizers , finalizerName ) {
logger . Info ( "执行删除前清理:备份数据、释放资源..." )
// 清理逻辑...
// 清理完成后,移除 Finalizer 让 CR 真正被删除
redisCluster . Finalizers = removeString ( redisCluster . Finalizers , finalizerName )
if err := r . Update ( ctx , & redisCluster ); err != nil {
return ctrl . Result {}, err
}
}
return ctrl . Result {}, nil
}
// ===== 步骤 3:构建期望的子资源 =====
// 根据 CR Spec 计算出应该有哪些 Service、ConfigMap、StatefulSet
desiredSvc := r . buildService ( & redisCluster ) // 构建期望的 Service
desiredConfigMap := r . buildConfigMap ( & redisCluster ) // 构建期望的 ConfigMap
desiredSts := r . buildStatefulSet ( & redisCluster ) // 构建期望的 StatefulSet
// ===== 步骤 4:确保 Service 存在并更新 =====
var existingSvc corev1 . Service
svcKey := client . ObjectKey { Name : redisCluster . Name , Namespace : redisCluster . Namespace }
if err := r . Get ( ctx , svcKey , & existingSvc ); err != nil {
if errors . IsNotFound ( err ) {
// Service 不存在——创建
if err := r . Create ( ctx , desiredSvc ); err != nil {
return ctrl . Result {}, err
}
logger . Info ( "Service 已创建" , "name" , desiredSvc . Name )
} else {
return ctrl . Result {}, err
}
} else {
// Service 已存在——对比并更新(只更新变化的部分)
existingSvc . Spec = desiredSvc . Spec // 只更新 Spec,保留 metadata
if err := r . Update ( ctx , & existingSvc ); err != nil {
return ctrl . Result {}, err
}
logger . Info ( "Service 已更新" , "name" , existingSvc . Name )
}
// ===== 步骤 5:确保 StatefulSet 存在并更新 =====
var existingSts appsv1 . StatefulSet
stsKey := client . ObjectKey { Name : redisCluster . Name , Namespace : redisCluster . Namespace }
if err := r . Get ( ctx , stsKey , & existingSts ); err != nil {
if errors . IsNotFound ( err ) {
if err := r . Create ( ctx , desiredSts ); err != nil {
return ctrl . Result {}, err
}
logger . Info ( "StatefulSet 已创建" , "replicas" , * desiredSts . Spec . Replicas )
} else {
return ctrl . Result {}, err
}
} else {
// StatefulSet 已存在——检查是否需要扩缩容
if * existingSts . Spec . Replicas != * desiredSts . Spec . Replicas {
existingSts . Spec . Replicas = desiredSts . Spec . Replicas
if err := r . Update ( ctx , & existingSts ); err != nil {
return ctrl . Result {}, err
}
logger . Info ( "StatefulSet 副本数已更新" ,
"from" , * existingSts . Spec . Replicas ,
"to" , * desiredSts . Spec . Replicas )
}
}
// ===== 步骤 6:更新 CR Status =====
redisCluster . Status . ReadyReplicas = int32 ( readyCount )
redisCluster . Status . Phase = "Running"
if err := r . Status (). Update ( ctx , & redisCluster ); err != nil {
logger . Error ( err , "更新 Status 失败" )
return ctrl . Result {}, err
}
logger . Info ( "CR Status 已更新" ,
"phase" , redisCluster . Status . Phase ,
"readyReplicas" , redisCluster . Status . ReadyReplicas )
// ===== 步骤 7:返回结果 =====
// ctrl.Result{RequeueAfter: 30 * time.Second} → 30秒后重新 Reconcile(定时对账)
// ctrl.Result{} → 不主动重试,等待下次 Watch 事件触发
return ctrl . Result {}, nil
}
// SetupWithManager 注册 Controller 到 Manager
func ( r * RedisClusterReconciler ) SetupWithManager ( mgr ctrl . Manager ) error {
return ctrl . NewControllerManagedBy ( mgr ).
For ( & cachev1 . RedisCluster {}). // 监听主资源
Owns ( & appsv1 . StatefulSet {}). // 监听子资源(StatefulSet 变化也会触发 Reconcile)
Owns ( & corev1 . Service {}). // 监听子资源(Service 变化也会触发 Reconcile)
Complete ( r )
}
// ===== 辅助函数:根据 CR Spec 构建子资源 =====
func ( r * RedisClusterReconciler ) buildStatefulSet ( rc * cachev1 . RedisCluster ) * appsv1 . StatefulSet {
labels := map [ string ] string { "app" : "redis" , "rediscluster" : rc . Name }
replicas := rc . Spec . Replicas
return & appsv1 . StatefulSet {
ObjectMeta : metav1 . ObjectMeta {
Name : rc . Name ,
Namespace : rc . Namespace ,
// ★ 设置 OwnerReference:这样 CR 被删除时 StatefulSet 自动级联删除
OwnerReferences : [] metav1 . OwnerReference {
* metav1 . NewControllerRef ( rc , cachev1 . GroupVersion . WithKind ( "RedisCluster" )),
},
},
Spec : appsv1 . StatefulSetSpec {
Replicas : & replicas ,
Selector : & metav1 . LabelSelector { MatchLabels : labels },
Template : corev1 . PodTemplateSpec {
ObjectMeta : metav1 . ObjectMeta { Labels : labels },
Spec : corev1 . PodSpec {
Containers : [] corev1 . Container {{
Name : "redis" ,
Image : fmt . Sprintf ( "redis: %s " , rc . Spec . Version ),
Ports : [] corev1 . ContainerPort {{ ContainerPort : 6379 }},
Resources : corev1 . ResourceRequirements {
Limits : corev1 . ResourceList {
corev1 . ResourceMemory : parseMemory ( rc . Spec . Memory ),
},
},
}},
},
},
},
}
}
// ... buildService()、buildConfigMap() 等其他辅助函数

 <!-- 这是一张图片,ocr 内容为: -->
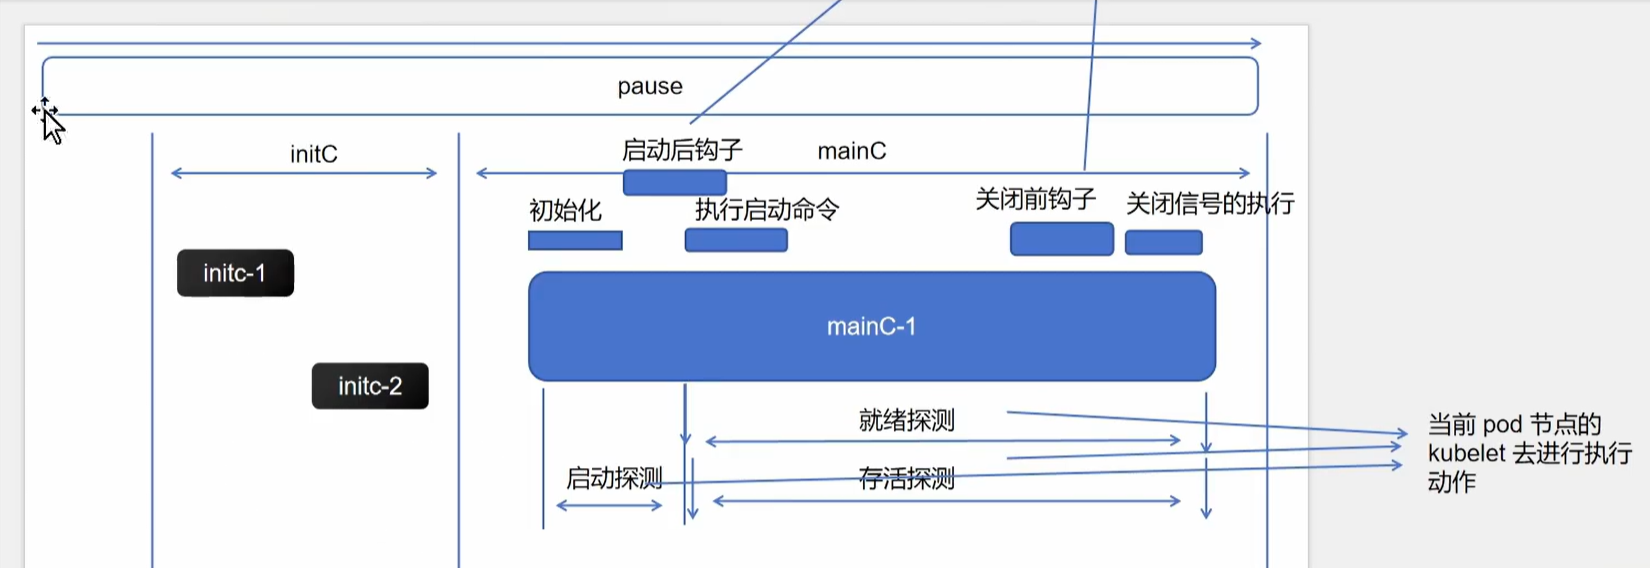
 <!-- 这是一张图片,ocr 内容为: -->
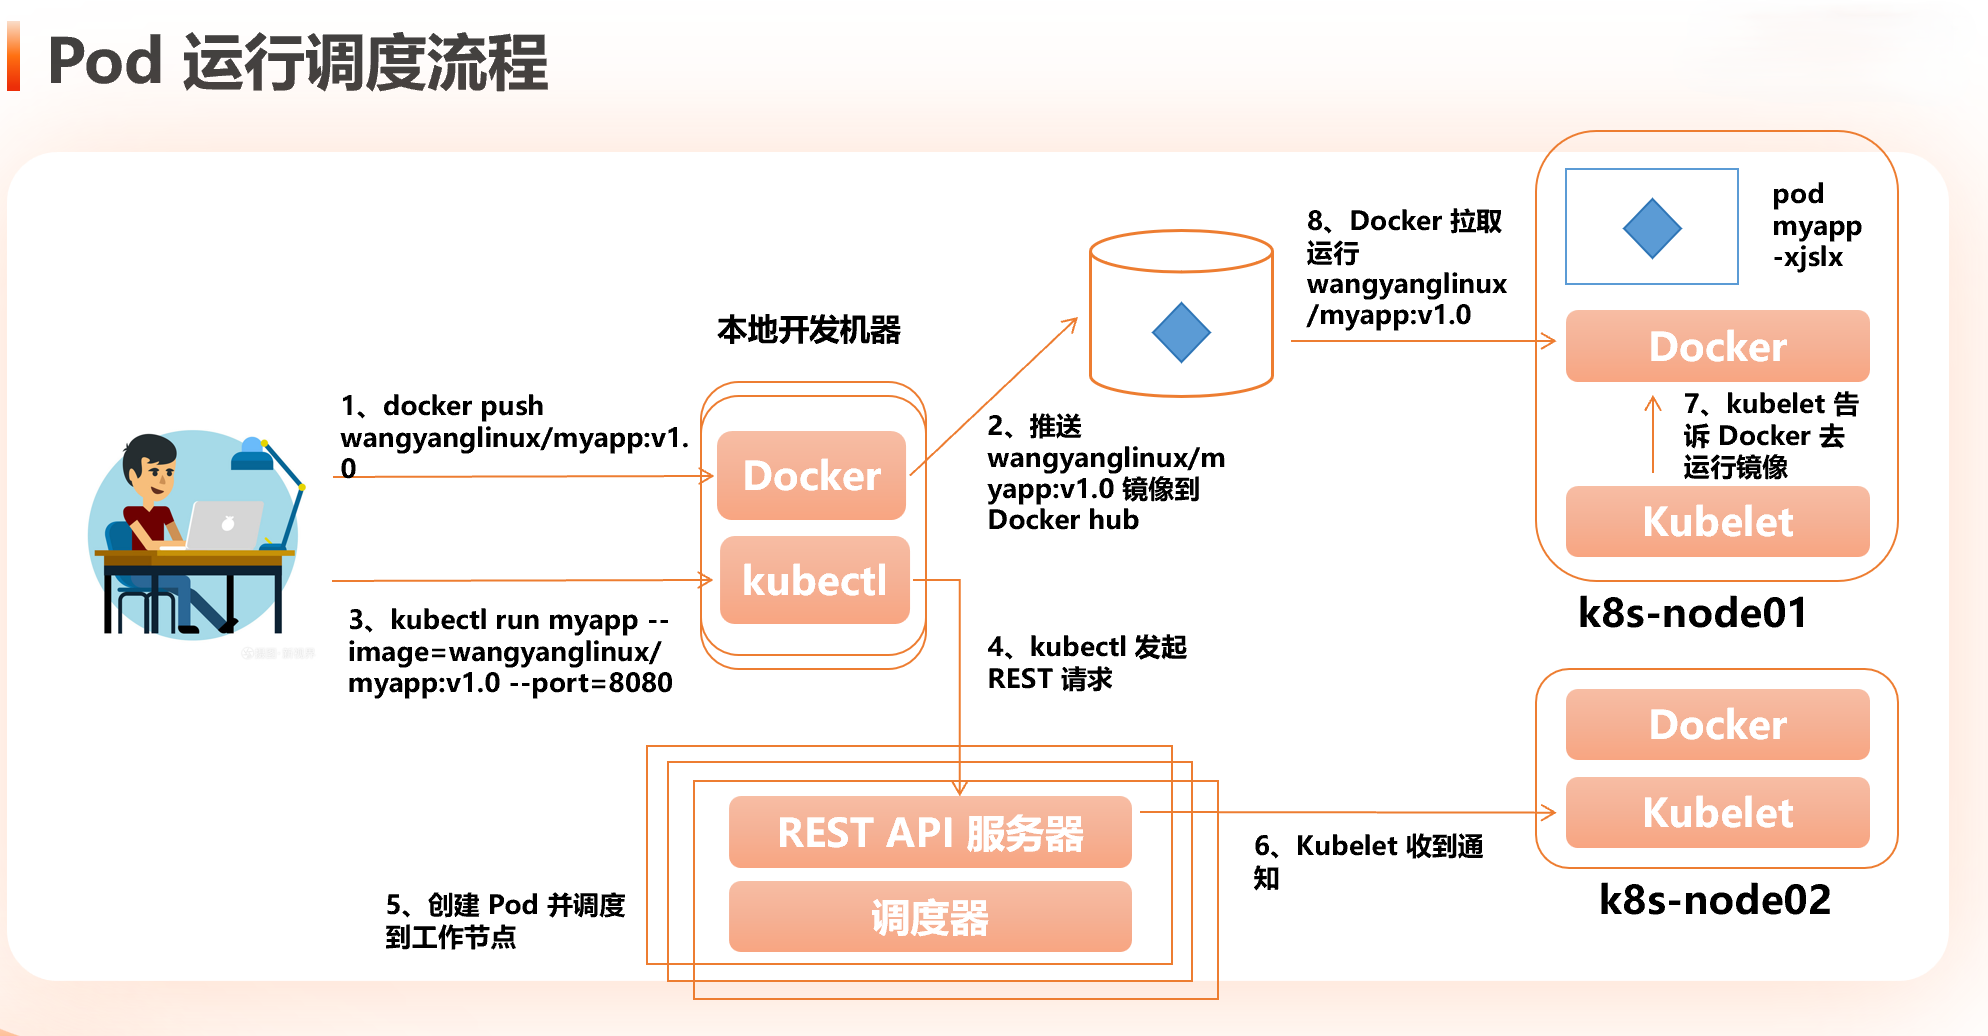
 <!-- 这是一张图片,ocr 内容为: -->
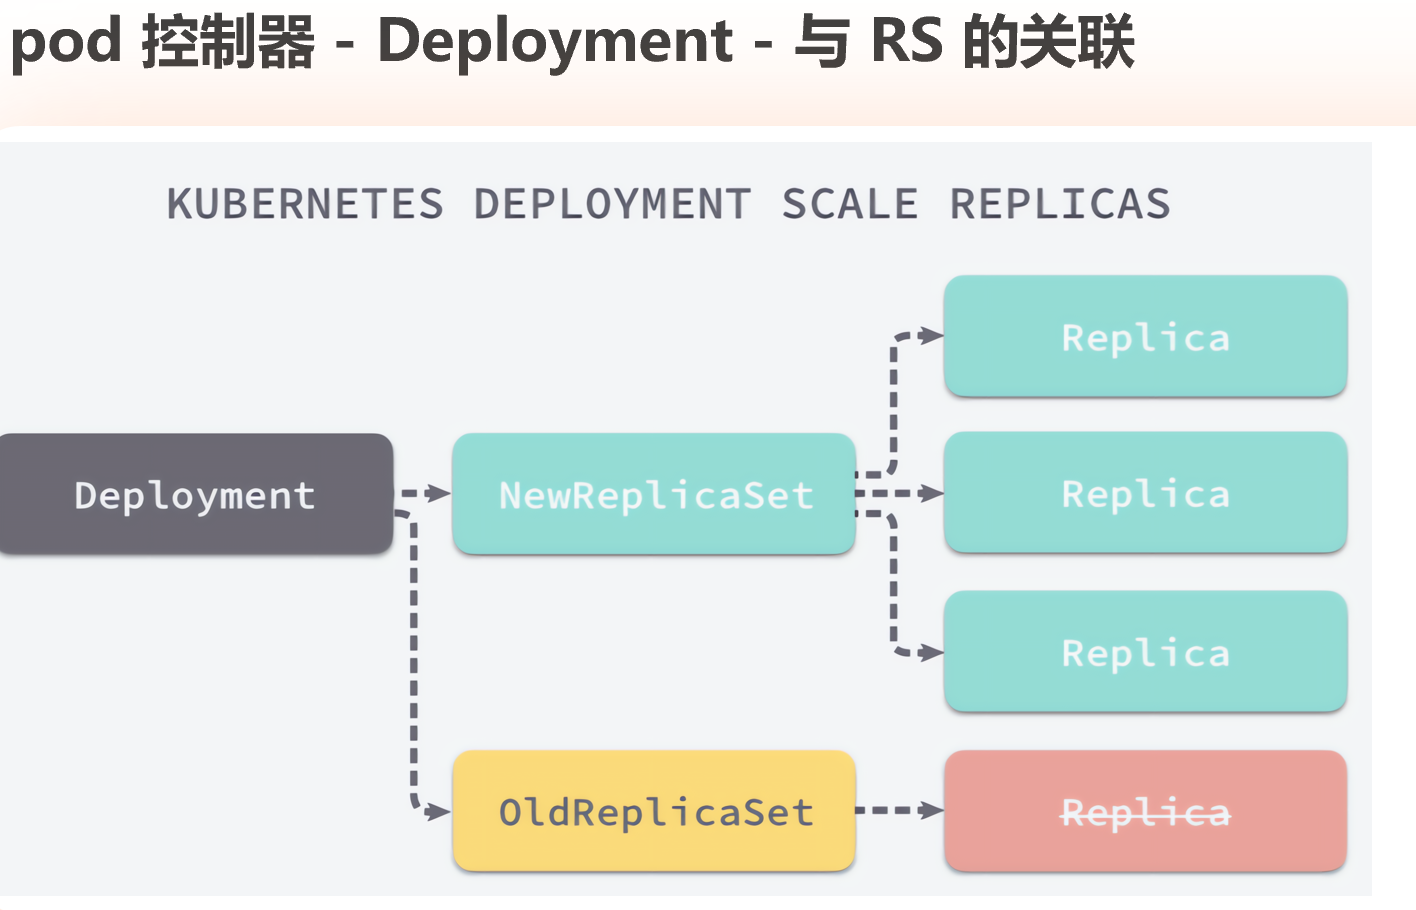
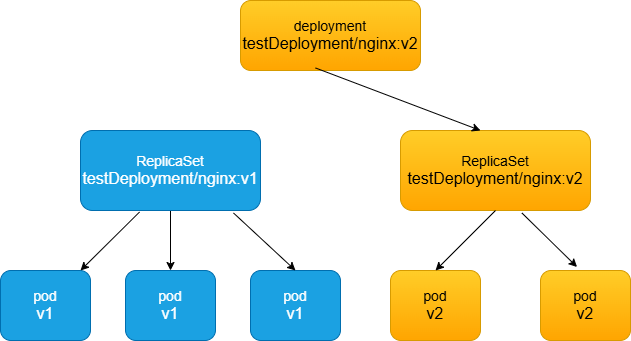
 <!-- 这是一张图片,ocr 内容为: -->
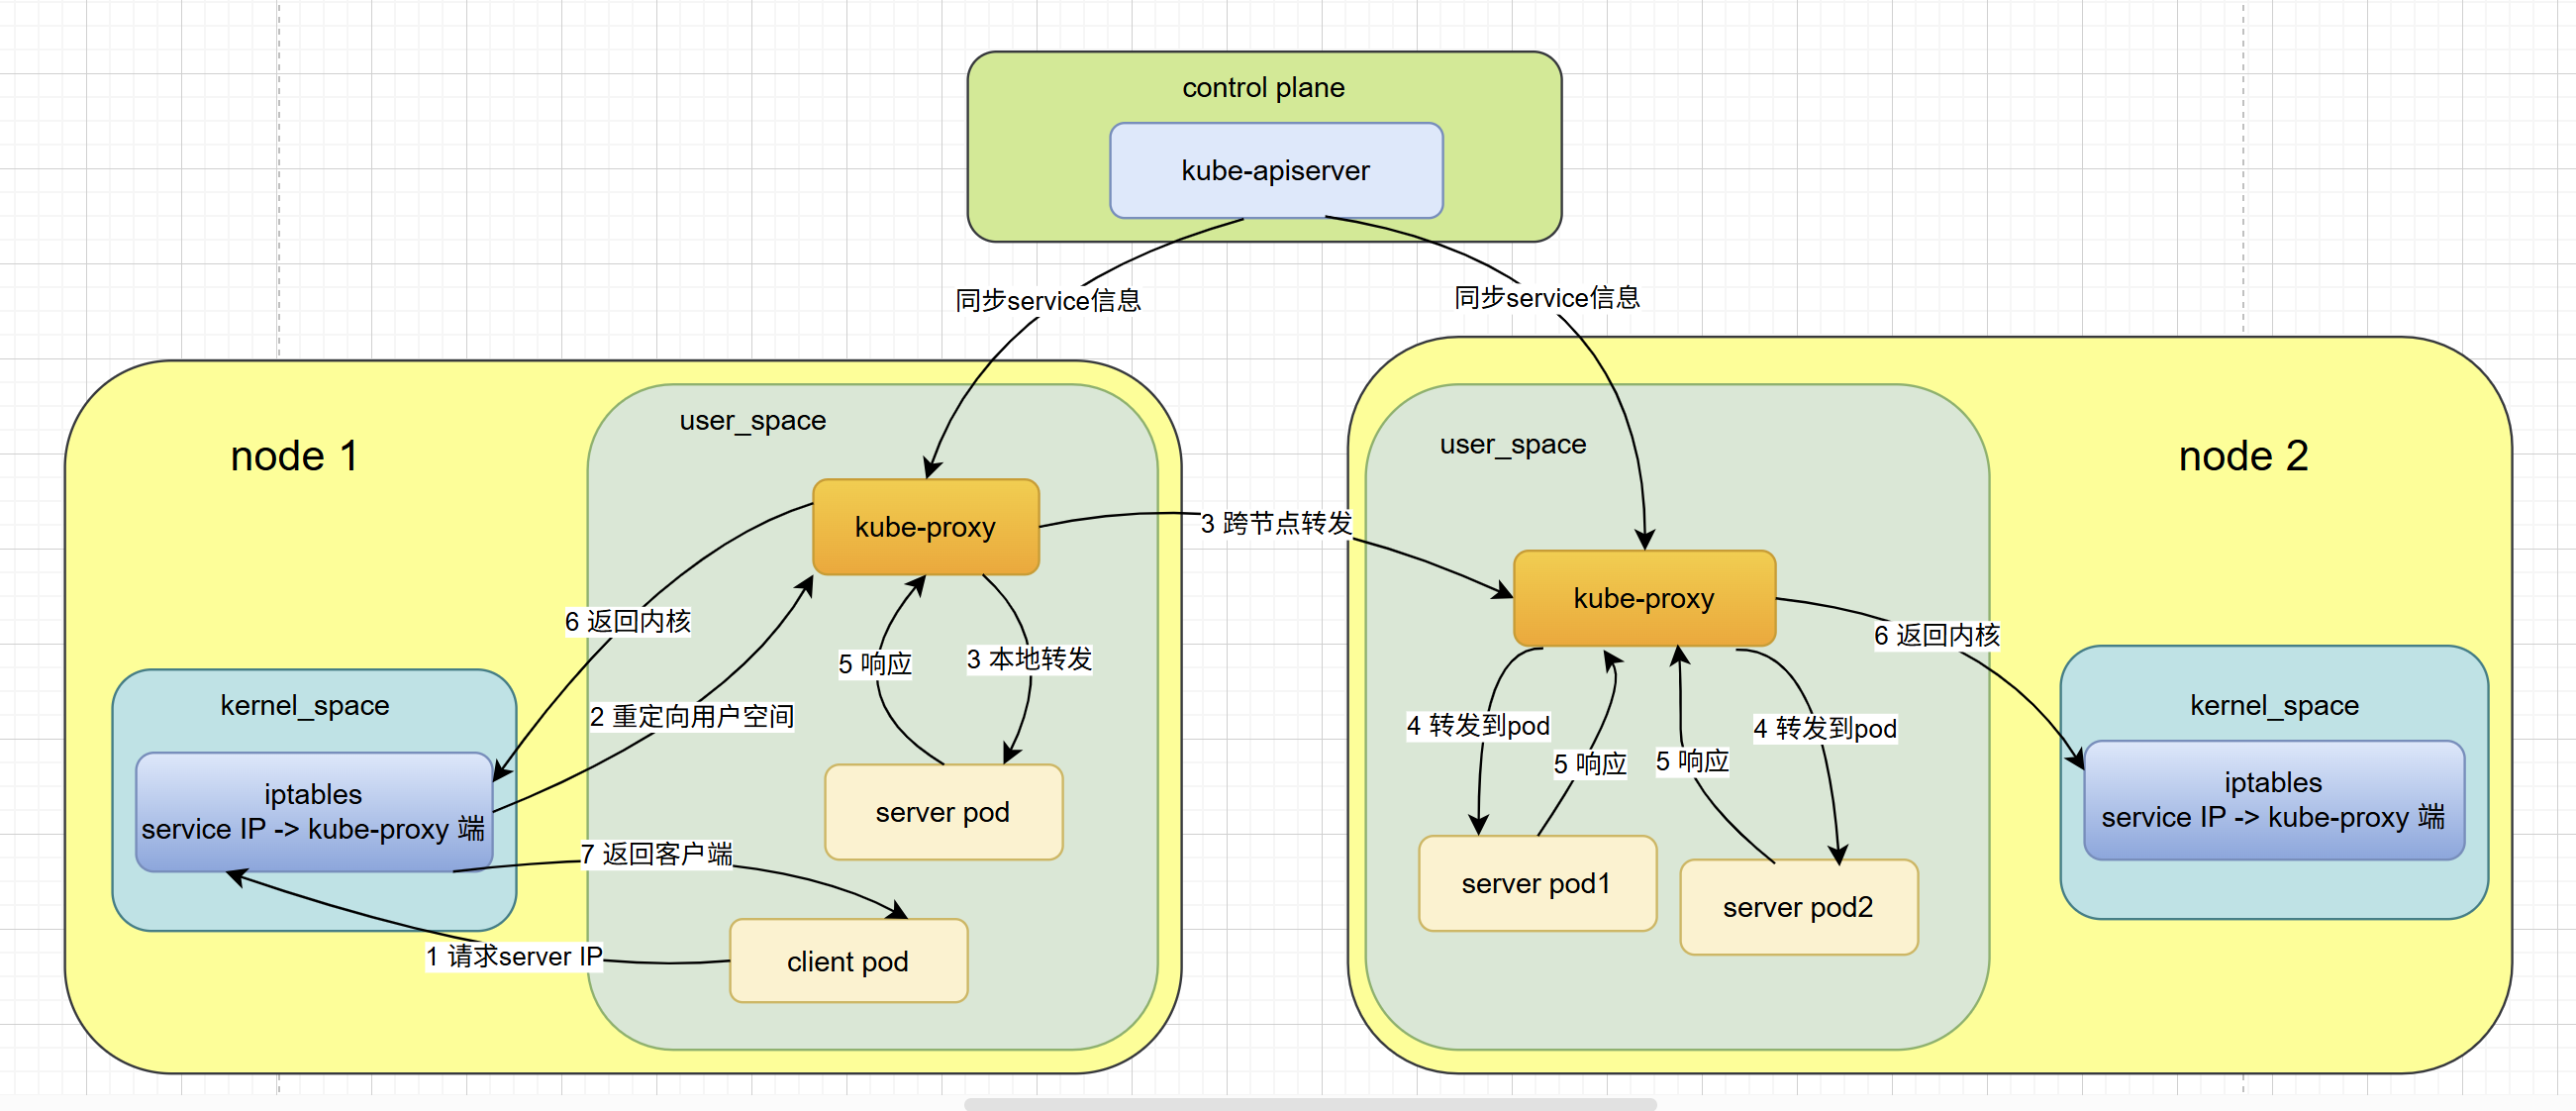


 <!-- 这是一张图片,ocr 内容为: -->
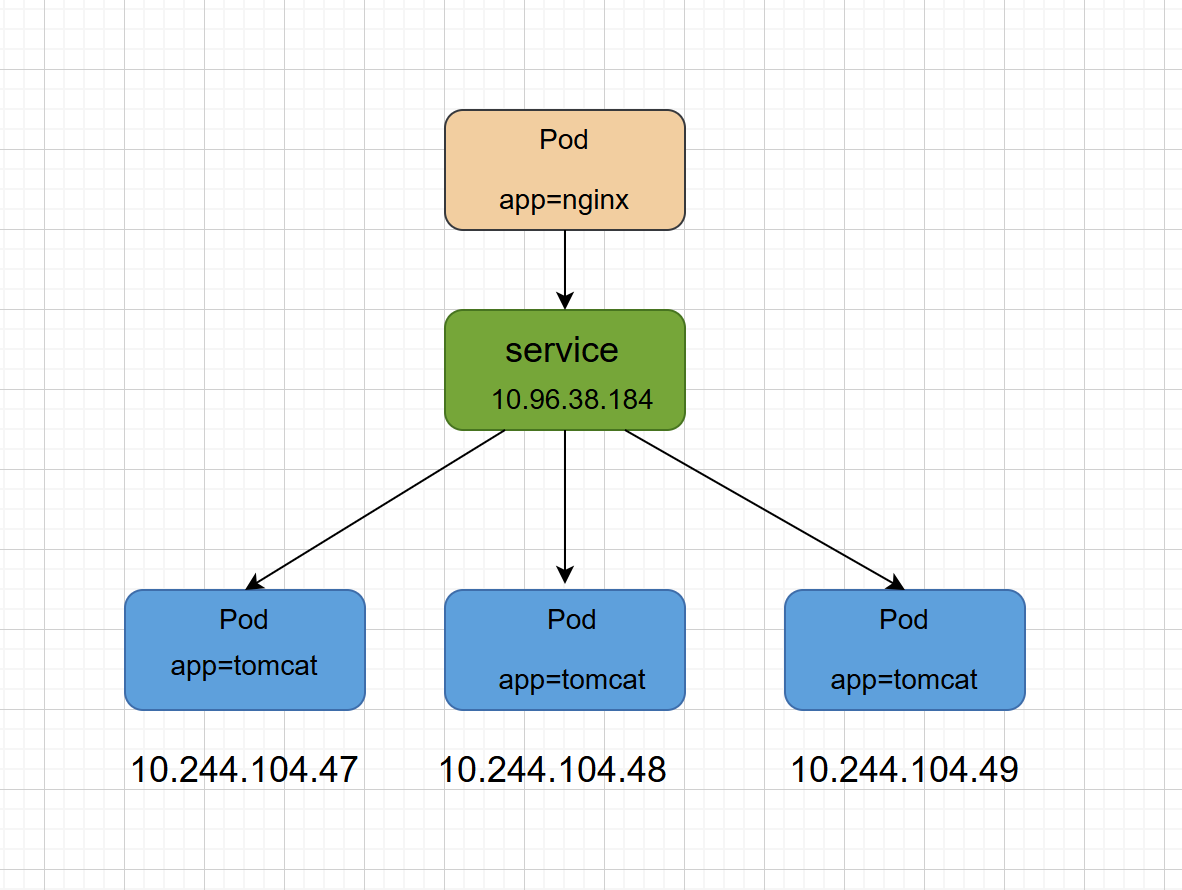
 <!-- 这是一张图片,ocr 内容为: -->
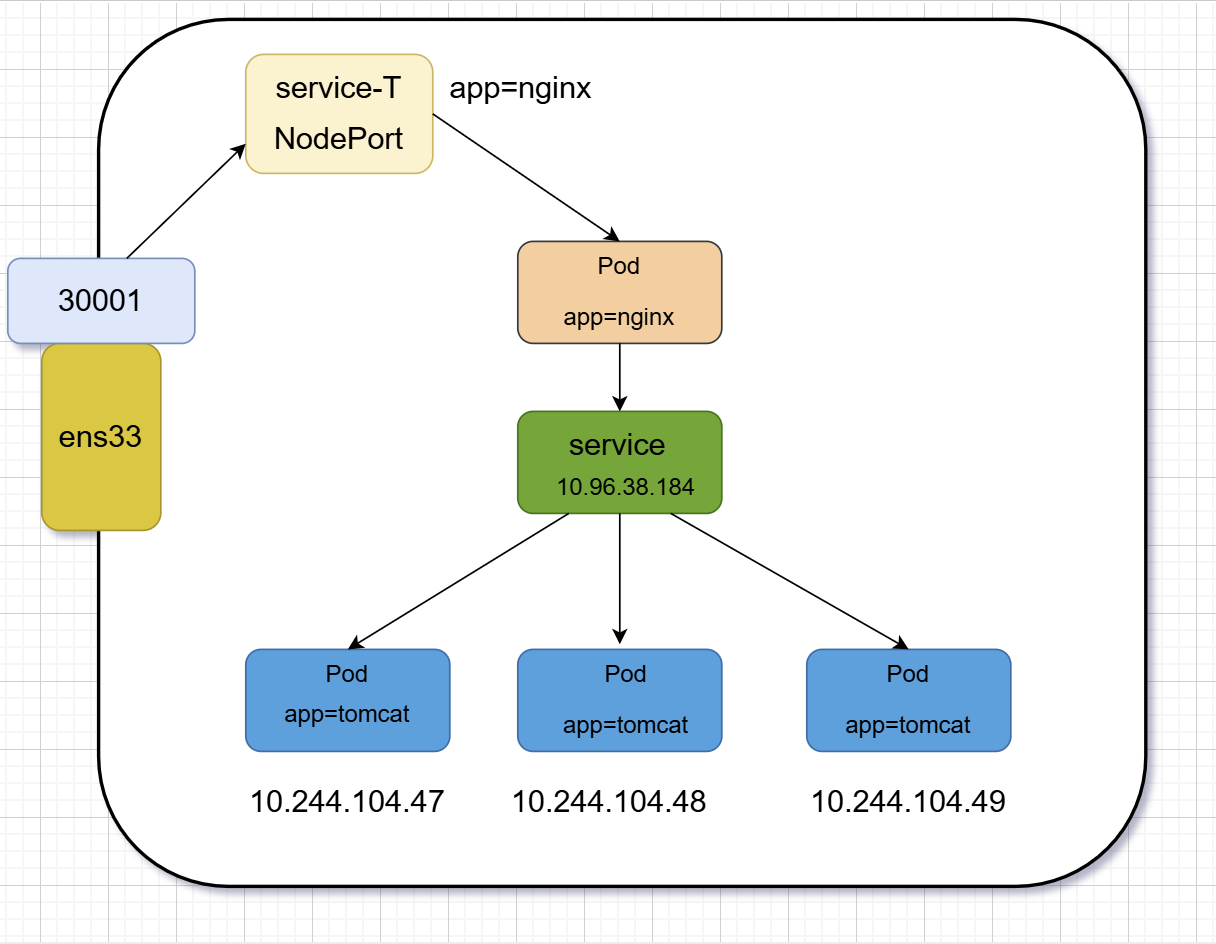
 <!-- 这是一张图片,ocr 内容为: -->
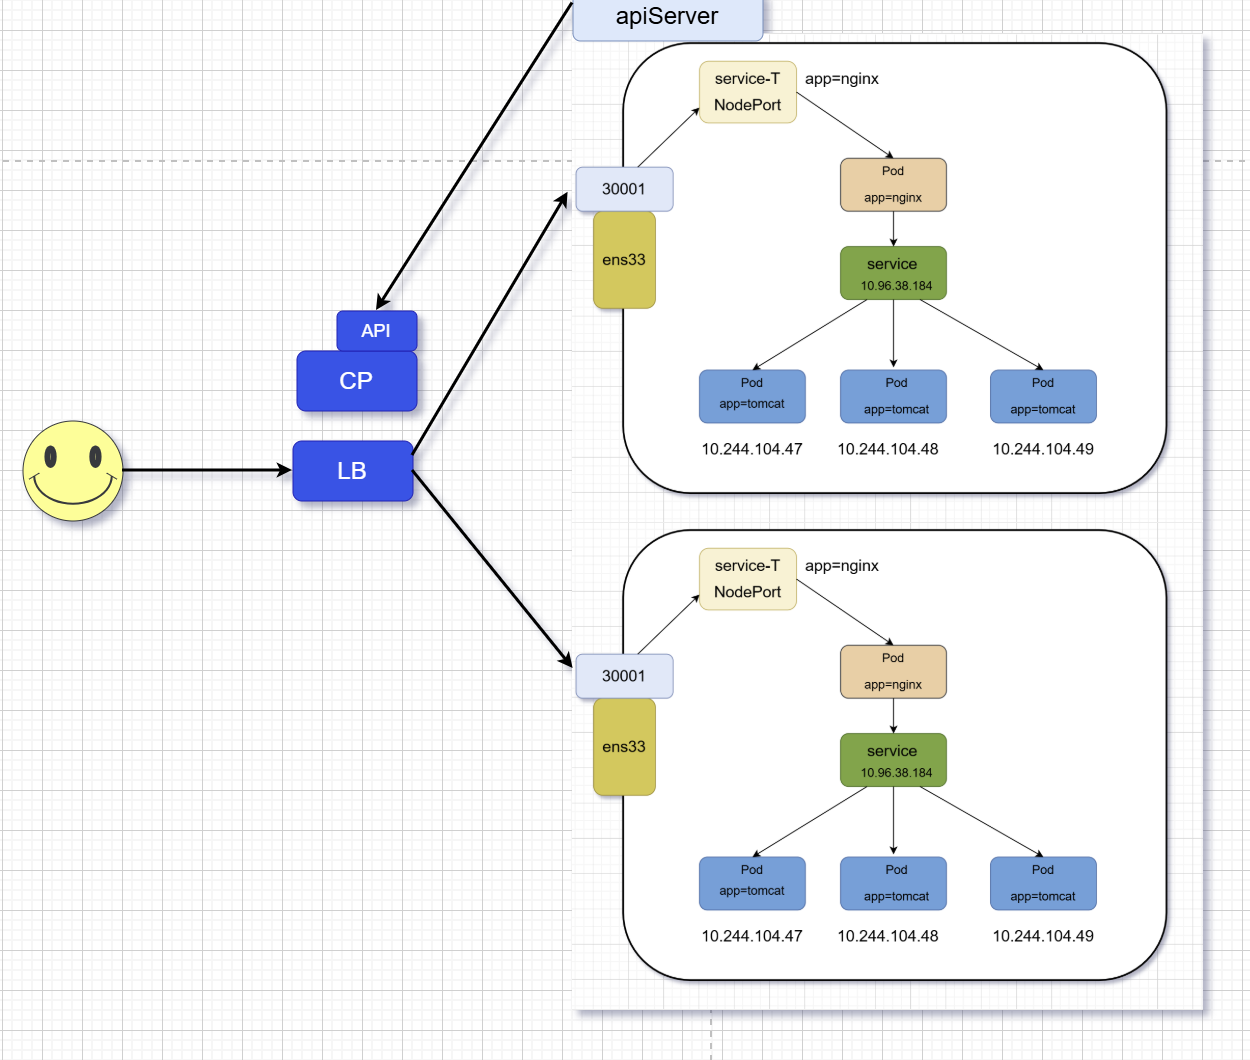
 <!-- 这是一张图片,ocr 内容为: -->
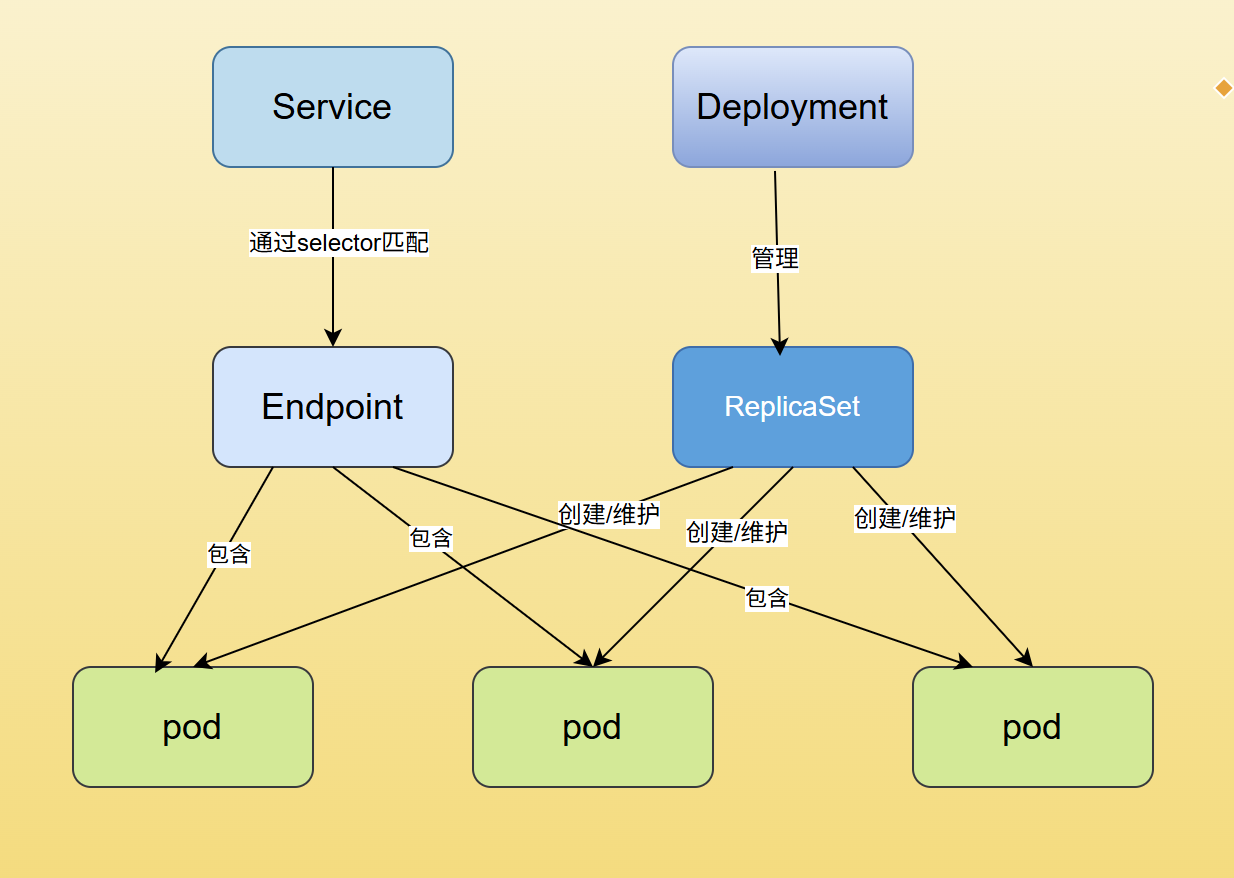
 <!-- 这是一张图片,ocr 内容为: -->
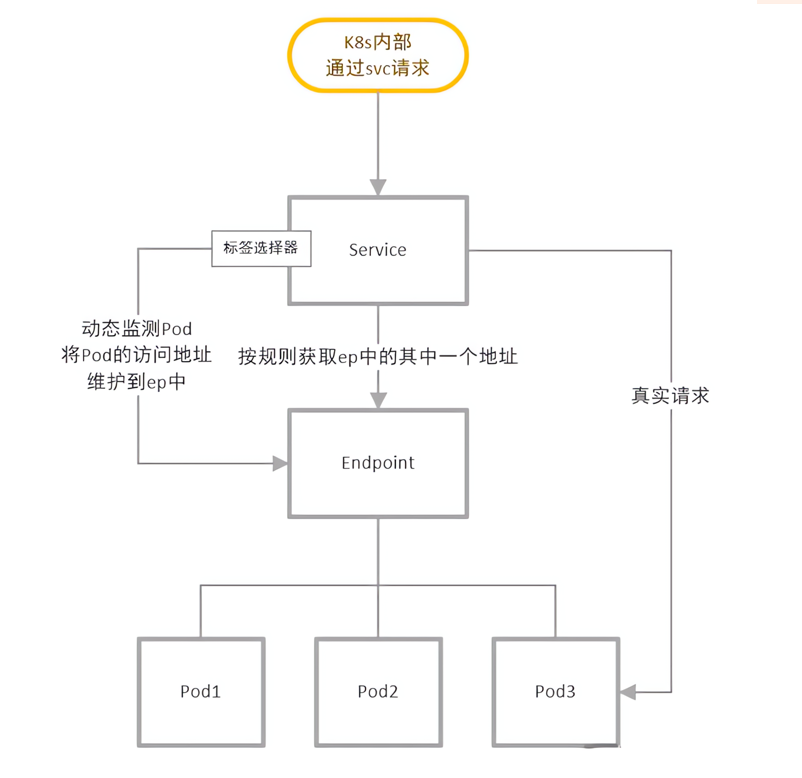
 <!-- 这是一张图片,ocr 内容为: -->